触覚・聴覚・力覚はAIの何を変える?マルチモーダル概念理解の最前線
画像認識の精度が高まった今も、ロボットが「柔らかいものを優しくつかむ」「見えない場所での接触を察知する」ことは簡単ではありません。視覚は物体の種類や形、配置の把握に強い一方で、硬さや摩擦、接触の瞬間といった物理的な情報は外観に現れにくいためです。
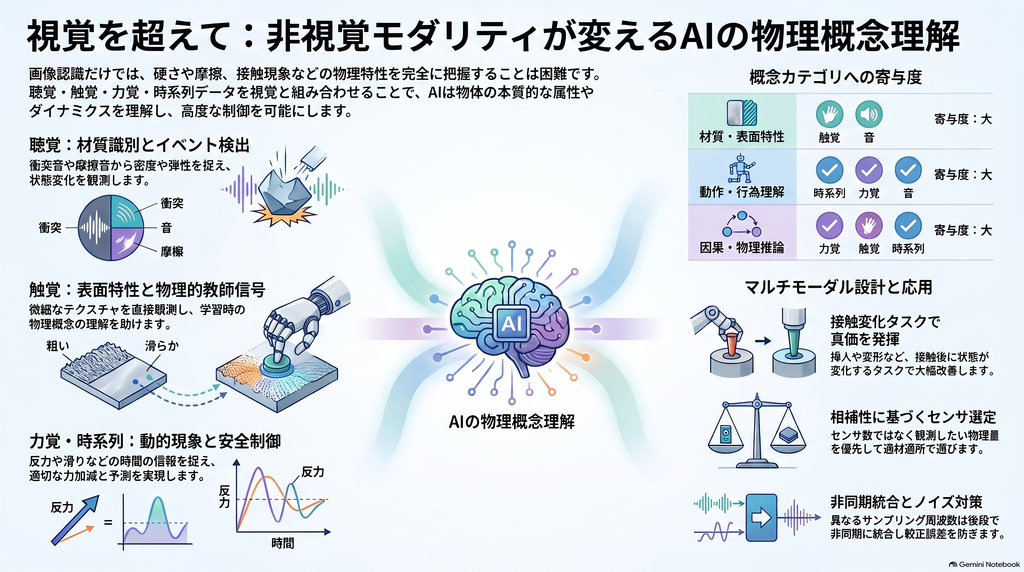
本記事では、聴覚・触覚・力覚・時系列データという視覚以外のモダリティが、どの概念理解を改善するのかを整理します。前半ではモダリティごとの得意領域を、後半では概念カテゴリ別の寄与と、マルチモーダル化を進める際の注意点を解説します。
視覚だけでは捉えにくい「物理的な概念」とは
視覚以外のモダリティが最も力を発揮するのは、視覚が苦手とする2種類の情報を扱う場面です。
外観から直接は観測できない物理量
硬さ、温度、表面の粗さ、弾性、密度などは、見た目が同じでも中身が異なることがあります。たとえば「同じ形・同じ色だが、片方は硬く片方は柔らかい」物体は、画像だけで区別するのが困難です。
接触後に初めて現れる動的現象
滑り始め、変形、衝突、摩擦、挿入時の引っかかりなどは、物体に触れてから時間とともに現れる現象です。さらに手や物体で視界が遮られると、視覚の優位性は急速に低下します。
ObjectFolder Benchmarkでも、視覚・音・触覚の最適な役割はタスクごとに異なることが示されており、「どのモダリティが何を観測しているか」を考えることが出発点になります。
聴覚:材質と「何が起きたか」を捉えるモダリティ
聴覚は「何が見えるか」より**「何が起きたか」**に強いモダリティです。衝突、摩擦、破砕、流動、接触開始といったイベントは短い音響信号として現れ、視覚が遮られた状況でも観測できます。
衝突音・摩擦音が材質識別に効く理由
叩いたときの音には、材料の弾性・密度・共振特性が反映されます。ObjectFolderの材質分類では、音単独の分類精度が視覚単独を上回り、三者融合でさらに向上したと報告されています。外観より音のほうが材質の手がかりとして識別的な場合がある、という示唆です。
また、50の実物体・15万件の衝撃音に接触力や衝撃位置、材質を付与したRealImpactのようなデータセットは、音がどの物理変数を符号化しているのかを切り分ける研究基盤として活用が期待されます。
硬い・柔らかいを音で見分ける
CoRLの「See, Hear, and Feel」では、視覚と触覚だけでは似た信号になる「硬い斜面」と「柔らかい斜面」を、接触音によって区別できました。聴覚は材質、状態変化、行為の区切り、イベント検出に寄与しやすい一方、静止した空間配置や大域形状の理解では寄与が比較的小さいと考えられます。
触覚:材質・表面・硬さの理解を支えるセンサ
触覚の最大の特徴は、表面のミクロな形状や、接触後に現れる物理特性を直接観測できる点です。
GelSightなど視覚型触覚センサの強み
GelSightのような視覚型触覚センサは、対象表面の高さマップを取得でき、テクスチャ分類や硬さ推定に活用されてきました。変形の様子から接触力や滑りを推定できる点も特徴です。
PHAC-2では、圧力・振動・温度などの触覚信号と、「hard/soft」「rough/smooth」「cold/warm」といった人間の触感語が対応付けられています。このデータを用いた研究では、視覚と触覚を融合したモデルが視覚単独より高い分類性能を示しました。
触覚は学習時の「物理的な教師信号」にもなる
CVPR 2017の「Connecting Look and Feel」では、布の厚さ・剛性・伸縮性などを視覚と触覚の共通表現として学習しました。注目すべきは、触覚を使った共同学習によって、推論時に視覚しか使わない場合でもモデルが改善し得ると報告された点です。触覚は単なる追加センサにとどまらず、物理概念を学ばせるための教師信号として働く可能性があります。
一方で、触覚は触れるまで情報が得られないため、大域的な空間把握には向いていません。
力覚:接触を伴う行為理解と安全な制御
力覚は、接触力・反力・拘束方向・摩擦・挿入誤差など、相互作用によって生じる変数を直接観測します。そのため、静的な物体認識よりも、物理推論、状態推定、制御、安全性への寄与が大きいモダリティです。
挿入タスクでの力覚の効果
InsertionNet 2.0は、ステレオ視覚と力・トルク入力を組み合わせ、複数の実世界挿入タスクで高い成功率を報告しています。ForceVLA2では、力の認識を明示的に組み込んだモデルが、接触の多いタスクで既存モデルを大きく上回ったとされます。「見た目だけではわからない、どの程度の力を出すべきか」を学ぶうえで、力覚が重要であることを示す結果です。
「優しく」「安全に」を理解する力覚
Taberoの研究では、視覚・触覚・言語から力と位置の指令を生成し、「優しく」という指示に対して把持力を抑えつつタスクを達成したと報告されています。成功率だけでは見えにくい、属性付きの行為理解に力覚が寄与する好例といえます。
時系列データ:滑り・変形・予測を学ぶための時間軸
時系列データは独立したセンサというより、音・触覚・力覚・自己受容感覚(proprioception)に含まれる時間の情報を保持する表現です。
「滑り始めた」「変形が進んでいる」「接触した直後」「次に失敗しそう」といった概念は、静止画像では捉えられず、時間軸を持たせて初めて学習できます。初期のロボット探索研究では、触感語の認識において動的な特徴を使う方法が静的な方法を上回りました。また、LSTMやTransformerで履歴を明示的に扱ったモデルが、未知物体への汎化で有利な結果を示した例もあります。
時系列化の寄与が特に大きいのは、動作・行為、滑り、接触イベント、時間予測、因果推論の領域です。
概念カテゴリ別:どのモダリティが寄与しやすいか
これまでの研究を横断すると、概念カテゴリごとの傾向は次のように整理できます。個々の数値の平均ではなく、研究結果を統合した定性的な見立てです。
| 概念カテゴリ | 寄与しやすい追加モダリティ | 期待される寄与 |
|---|---|---|
| 物体認識 | 音、触覚、時系列 | 中 |
| 材質・表面特性 | 触覚、音 | 大 |
| 硬さ・温度などの状態 | 触覚、力覚 | 大 |
| 動作・行為理解 | 時系列、力覚、音 | 大 |
| 因果・物理推論 | 力覚、触覚、時系列 | 大 |
| 時間パターン・予測 | 時系列、音、力覚 | 大 |
| 空間関係・配置 | 視覚、触覚 | 小〜中 |
| 音・触感の意味理解 | 音、触覚 | 大 |
大きな改善が見られやすいのは、単純な画像分類よりも接触後に状態が変化するタスクです。「See, Hear, and Feel」の密集挿入タスクでは、視覚単独では成功率が低かったものの、音と触覚を加えることで大幅に改善しました。音は硬軟の識別、触覚は局所的な傾きの識別と、それぞれ異なる変数を補ったことが効いています。
マルチモーダル化の落とし穴と実験設計のポイント
モダリティ追加が常に改善とは限らない
ObjectFolderの接触位置推定では、三者融合が二者の組み合わせを下回るケースが報告されています。センサの較正、同期、融合方式、ドメインシフトによっては、追加したモダリティがノイズ源になる可能性があります。対策として、モダリティの欠損を想定した学習(modality dropout)や、信頼度に応じた重み付け(confidence gating)、欠損時の評価を組み込むことが推奨されます。
同期・周波数・交絡要因への対策
カメラ、触覚センサ、力センサ、マイクはサンプリング周波数が大きく異なるため、単純にフレーム単位で連結すると情報を損なうおそれがあります。モダリティごとにエンコーダを持ち、後段で非同期に統合する設計が妥当です。
また、触覚は接触速度や押し付け力、探索の軌道に強く影響されます。評価データは物体だけでなく、速度、把持位置、グリッパ、センサ個体をまたいで分割することが望まれます。比較の際は、モデルの容量をそろえて「情報量による改善」と「モデルの大きさによる改善」を切り分けることも重要です。
まとめ:センサの数ではなく「相補性」で選ぶ
視覚以外のモダリティの価値は、認識精度の数ポイントの上積みだけで測ると過小評価されがちです。効果が大きいのは、見た目と物理状態が一致しない場面です。
- 材質・表面:触覚と音
- 硬さ・温度などの状態:触覚と力覚
- 動作・行為、因果推論:力覚・触覚・時系列
- 予測:時系列
- 空間配置:依然として視覚が中心
実務的には、視覚+手首の力覚センサ+指先の触覚センサを基本構成とし、材質やイベント性の高いタスクでは音を加えるのが、費用対効果の高い選択肢になり得ます。すべてのセンサを常に搭載するより、観測したい物理量を先に決め、それを直接捉えるセンサを選ぶことが合理的です。
今後の掘り下げとしては、「どのモダリティを入れるか」から「いつ、どのモダリティを信頼するか」への移行、学習時だけ触覚や音を使い推論時はカメラのみで動かすセンサ削減の手法、そして時間そのものを研究変数として扱うアプローチが注目されます。
コメント