LLMの「知識の穴」を診断する方法|解釈可能性で特定し狙い撃ちで補完
大規模言語モデル(LLM)が誤答したとき、データを足して再学習するだけでは、原因が「未学習」なのか「誤った関連付け」なのか「知識はあるのに使われていない」のかを区別できません。結論から言えば、内部表現を概念単位で観察し、介入実験で因果関係を確かめてから、穴の種類に合った最小限の補完をすることが、副作用の少ない改善の近道になります。
本記事では、概念を特定する解釈可能性の手法、知識の穴の分類と検出、補完手法の選び方、再現性のあるワークフローを順に解説します。
LLMの「知識の穴」とは?解釈可能性で診断すべき理由
QAの不正解だけでは穴の原因がわからない
「知識の穴」を単に質問への不正解と捉えると、検索の失敗、プロンプトへの過敏さ、出力段階の失敗、本当の未学習が一緒くたになってしまいます。そこで、入力分布・内部表現・因果的な利用・出力行動の4つの層で観察し、どこで知識が途切れているかを見ることが重要です。
「概念=単一ニューロン」という仮定の落とし穴
少数のニューロンで読み取れる概念がある一方、多くの概念は複数ニューロンにまたがる分散表現として存在する可能性が報告されています。そのため、ニューロン・線形方向・低次元の部分空間・疎な特徴を並行して調べる姿勢が求められます。
LLM内部の概念を特定する解釈可能性の代表的手法
ニューロン帰属とスパースプロービング
Knowledge Neurons は、特定の事実と結びつくFFN(フィードフォワード層)のニューロンを帰属分析で特定する手法です。スパースプロービングは「少数のニューロンでどこまで概念を読めるか」を比べられます。どちらも低コストですが、読み取れることと、モデルがその情報を実際に使っていることは別問題です。
概念ベクトル(CAV)と活性化ステアリング
正例と負例の活性化の差から「概念の方向」を推定する手法です。少ない例で方向を得られ、そのまま推論時の介入にも使えます。ただし、制御に有効な方向が、モデルが自然に持つ概念表現と同じとは限りません。
SAE(スパースオートエンコーダ)による特徴抽出
SAEは内部の活性化を大量の疎な特徴に分解する辞書学習の手法で、ラベルなしで未知の概念を広く探索できる点が強みです。大規模な商用モデルでも都市・科学分野・コード構造などの特徴が見つかり、特徴を強めると出力が対応する方向に変わることが示されています。一方で、辞書サイズや学習データに結果が左右され、SAEで特徴が見つからないことは、モデルがその知識を持たないことを意味しない点に注意が必要です。
DASと活性化パッチングによる因果検証
活性化パッチングは、正常な入力と壊した入力の内部状態を入れ替え、どの層・位置が出力に必要かを直接測ります。DAS(Distributed Alignment Search)はニューロン基底に縛られず、高水準の因果変数に対応する部分空間を学習します。概念を見つけた後の「本当に使われているか」の確認に欠かせない手法です。
実務上は、読み取り(デコード)→介入→行動の変化という3段階の証拠をそろえることが最低限の要件になります。
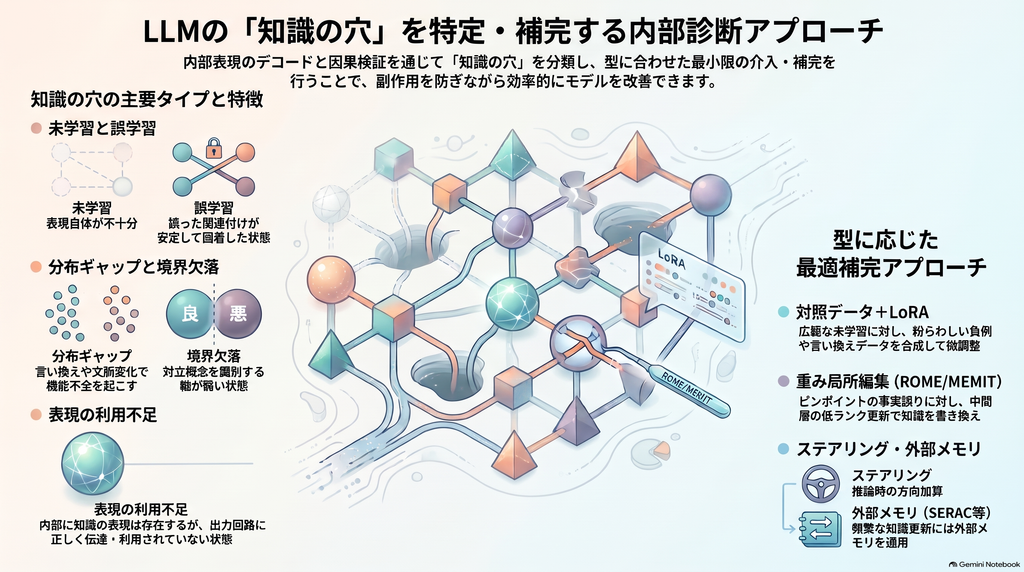
知識の穴の4分類と検出方法
未学習・誤学習
未学習は、正解に対応する表現が安定して読み取れず、介入しても正答が自然に回復しない状態です。複数回生成した回答の意味的なばらつきを測る semantic entropy が高く、プロービングやSAEでも根拠が弱いことが手がかりになります。
誤学習は、誤った関連付けが安定して符号化され、実際に使われている状態です。言い換えても同じ誤答を自信を持って返す傾向があり、その方向を取り除くと改善する場合があります。semantic entropy は自信のある誤答を見逃しやすいため、内部表現の診断と組み合わせることが大切です。
分布ギャップ・対立概念の欠落
分布ギャップは、通常のプロンプトでは正しく動く仕組みが、言い換え・別言語・文脈の変化で起動しなくなる状態です。分布外データでのプロービングや、言語間での活性化の比較で検出できます。
対立概念の欠落は、概念Aの方向はあるのに、Bや「Aではない」を区別する軸が弱く、一方向に偏った一般化を起こす状態です。対照的なCAVやDAS、概念消去(INLP・LEACE)で境界の弱さを確かめます。
「表現はあるのに使われない」穴と抽出器側の見落とし
4分類に加えて、プローブでは概念を読めるのに出力回路に流れていない利用不足や、モデルは知っているのにSAEやプローブが特徴を拾えない抽出器側の穴も区別しておく必要があります。後者を「知識の欠落」と誤認すると、不要な編集でモデルを壊すおそれがあります。
知識の穴を狙い撃ちで補完する手法の選び方
広範な未学習には対照データ合成+LoRA
概念クラス全体が弱い場合は、微調整やLoRAが素直な選択です。正例だけを足すと境界が動きすぎるため、言い換え・近い概念・反例・紛らわしい負例を組み合わせた対照的なデータを合成し、内部表現の「足りないセル」を埋める発想が有効です。
局所的な事実誤りにはROME・MEMIT・AlphaEdit
ROMEは因果トレーシングで重要な中間FFNを特定し、低ランクの重み更新で事実を書き換えます。MEMITはこれを多数の事実に拡張し、AlphaEditは既存知識を壊しにくいよう更新方向を制約する設計です。
利用不足には活性化ステアリング、頻繁な更新には外部メモリ
表現はあるのに弱すぎる場合は、推論時に方向を加える活性化ステアリングが低コストな応急処置になります。事実が頻繁に変わる、編集の取り消しが必要といったケースでは、重みを変えずに外部メモリで出力を補正するSERACや検索拡張が向いています。
「知識がある場所」と「編集すべき場所」は一致しない
因果トレーシングで知識が強く局在する層と、編集が最もうまくいく層は必ずしも一致しないと報告されています。「見つけた場所を直す」を機械的に当てはめず、診断と編集層の選択を別々の実験課題として扱うべきです。
再現可能な診断・補完ワークフロー
6ステップの閉ループ
- 行動テストで知識の基準線を測る
- プローブ・SAE・CAVで候補表現を探す
- パッチング・消去・DASで因果性を確認する
- 穴の型を分類する
- 型に合った最小介入で補完する
- 対象への効果と副作用を同時に評価し、回帰テストに組み込む
評価指標と統計的な注意点
編集の評価では、成功率(reliability)、言い換えへの汎化、無関係な入力を変えない局所性(locality)、関連する推論への波及(portability)、分布外での頑健性を同時に見ます。SAEは再構成誤差や疎性だけで良し悪しを判断せず、介入時の効果も併記しましょう。
統計面では、同じ問題の編集前後比較にはMcNemar検定や対応のある並べ替え検定・ブートストラップが適しています。多数の層や特徴を探索する場合は多重比較の補正が必要です。何より、特徴の発見に使ったデータと因果検証のデータを分けることが、相関を因果と取り違えないための鍵です。
実装に使えるオープンソースツール
活性化の取得とフックにはTransformerLens、学習済みSAEの利用と学習にはSAELens、介入やDASにはpyvene、ROME・MEMIT・SERACなどの編集手法の比較にはEasyEditが使えます。実験ではトークン位置・チャットテンプレート・生成温度を固定し、ゼロ・平均・リサンプルなど複数のアブレーション基準で結論が再現するかを確かめると安心です。
まとめ:解釈可能性で知識を補完するための要点
- 知識の穴は不正解ではなく、表現・因果的利用・頑健性の観点から型として診断する
- 概念は単一ニューロンとは限らず、方向・部分空間・疎な特徴を並行して調べる
- 「特徴が見つからない」ことは「知識がない」ことを意味しない
- 補完手法は穴の型に合わせて選び、局在場所と編集場所を混同しない
- 診断→因果検証→最小介入→回帰評価の閉ループで副作用を管理する
今後は、SAE辞書が内部概念をどこまで網羅しているかの検証や、特徴が回路の中で何を計算しているかの解明、連続編集による表現の歪みへの対策が、この分野を実用に近づける重要なテーマになると考えられます。
コメント