導入
対話AIに「この答えは私のことを考えてくれている」「AIが自信を持って言っているから正しそう」と感じたことはないでしょうか。このように、AIに人間らしい意図や感情を読み取る傾向をユーザー側の擬人化バイアスと呼びます。
生成AIが日常の情報収集や意思決定に入り込むなかで、このバイアスはAIへの信頼、誤情報の見抜きやすさ、さらには過剰な依存に関わる可能性があります。本記事では、擬人化バイアスの心理的な仕組み、信頼性判断への影響、測定方法、実験デザイン、倫理面の注意点を順に解説します。
擬人化バイアスとは?対話AIに「心」を見てしまう心理
擬人化とは、人間ではない対象に、意図・動機・感情といった人間特有の性質を当てはめる認知傾向です。対話AIは自然な文章で応答するため、とりわけ擬人化が起こりやすい対象といえます。
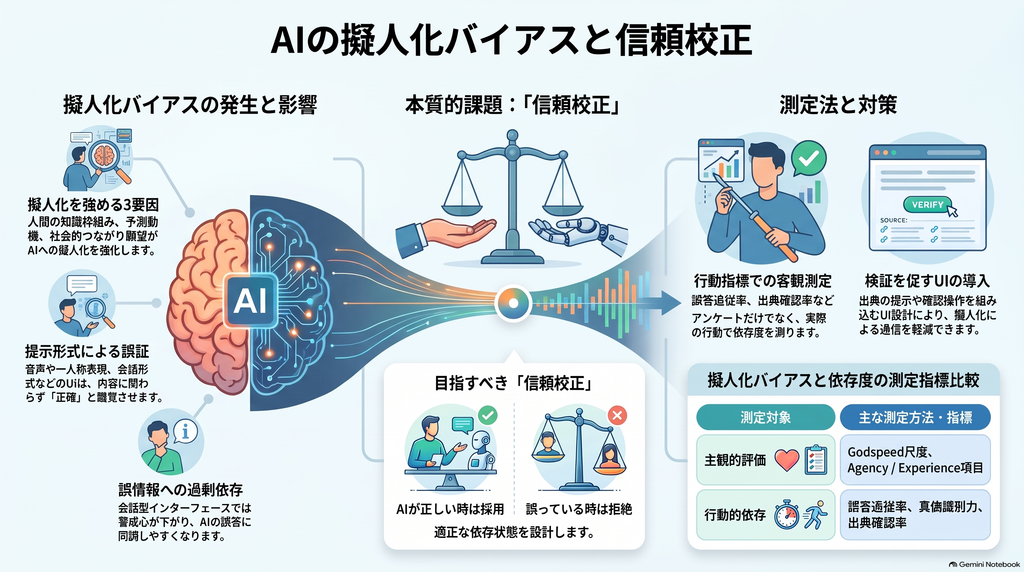
擬人化を強める3つの要因
心理学の代表的な理論(Epleyらの三要因理論)では、擬人化は次の3つの要因で強まるとされています。
- 人間についての知識が使いやすいこと:人間を理解する枠組みを、そのまま対象に当てはめてしまう
- 理解・予測したい動機:AIの振る舞いを説明したいとき、「意図があるから」と考えると納得しやすい
- 社会的つながりへの動機:孤独感が強いときなど、対象に人とのつながりを求めやすくなる
つまり擬人化は「AIが人間らしいから」だけでなく、ユーザー自身の状態や動機によっても強さが変わります。研究ではAI側の設計とユーザー側の個人差を両方とらえる必要があります。
「意図の帰属」と「感情の帰属」は分けて考える
心の知覚研究では、人が他者に心を認める判断は、計画や自己統制などの**Agency(主体性)と、感情や痛みを感じるExperience(経験)**に分けられるとされています。
「AIが意図してこの答えを選んだ」と感じることと、「AIが私を気遣っている」と感じることは別の現象です。前者は回答の正確さへの評価、後者は親しみや好意に結びつきやすいと考えられるため、両者を分けて扱うことが重要です。
擬人化バイアスがAIへの信頼性判断に与える影響
声・一人称・会話形式が「正確そう」に見せる可能性
LLMを対象とした実験研究では、音声とテキストを組み合わせた提示が、テキストのみの提示に比べて擬人化の評価と情報の正確性評価を高めたと報告されています。一人称表現も、文脈によっては評価に影響したとされます。
ここで注目すべきなのは、回答の中身は同じでも、提示の仕方だけで「正しそう」という印象が変わる可能性がある点です。
擬人的な説明だけでは効果が出ないケースもある
一方で、AIを擬人的な言葉で説明するだけでは、信頼や依存に明確な差が見られなかったという研究もあります。擬人化の効果は単純ではなく、声、自己開示、感情表現、応答の適応性といった複数の手がかりが重なったときに表れる可能性があります。
会話形式は誤情報を見抜きにくくする可能性
同じ内容でも、静的な文章として読むより、会話エージェントとして提示されたほうが不正確さに気づきにくいという実験結果があります。また、会話性の高いAIは誤情報を含む回答への信頼を高めうる一方、ユーザーに検証操作を行わせるとその信頼が下がったとの報告もあります。
このことは、UI設計によって擬人化のリスクを和らげられる可能性を示しています。
本当の論点は「信頼の高さ」ではなく「信頼校正」
自動化バイアスとの共通点
この問題は、古くから知られる自動化バイアスとも重なります。自動化支援を使う人は、システムが警告しないために異常を見落としたり、正しい情報があるのにシステムの提案を採用したりする傾向が報告されています。
対話AIでいえば、「自分は正しく答えていたのに、AIの誤答に合わせて回答を変えてしまう」行動がこれにあたります。
適切な依存と過剰依存の違い
重要なのは、AIをよく使うこと自体を問題視しないことです。評価すべきは次の2点です。
- 適切な依存:AIが正しいときに採用し、誤っているときには採用しない
- 過剰依存:AIが誤っているときにも採用してしまう
人はAIを常に好むわけでも、常に避けるわけでもなく、課題や専門性によって態度が変わります。そのため研究の目的は「擬人化が信頼を高めるか」ではなく、擬人化がどの条件で信頼を適正化し、どの条件で過信に変えるのかを明らかにすることに置くのが妥当です。
擬人化バイアスの測り方:主な尺度と指標
個人差と状態を分けて測る
擬人化は「もともとの傾向」と「その場で感じた人間らしさ」に分けて測定します。
| 測りたいもの | 主な測定方法 |
|---|---|
| 特性的な擬人化傾向 | IDAQ系の項目(日本語化は翻訳・逆翻訳で検証) |
| その場の擬人化 | Godspeed尺度の擬人化項目+LLM向けの独自項目 |
| 心の帰属 | Agency/Experienceの項目 |
| 主観的な信頼 | Trust in Automation尺度の適応版 |
| 情報源としての信頼 | 能力・信頼性・善意を分けるソース信頼性尺度 |
| 認知負荷 | NASA-TLX |
特に、「正確そう」という評価と「優しそう」という評価を区別することが大切です。AIが親切に感じられても、それは事実としての正確さとは別のものだからです。
自己報告ではなく行動で依存を測る
「このAIを信頼しますか」という質問だけでは、実際の行動はわかりません。そこで次のような行動指標が役立ちます。
- 誤答追従率:AIが誤答したときにAIの回答を採用した割合
- 真偽識別力:正しい情報と誤った情報を見分けられた程度(信号検出理論の指標も利用可能)
- 出典確認率:「出典を確認」ボタンを押した割合や滞在時間
擬人化バイアスを検証する実験デザイン
内容を固定し、社会的な手がかりだけを変える
信頼性の高い実験にするには、すべての条件で回答内容を同じにし、名前・声・一人称・絵文字・自己開示・感情表現といった社会的な手がかりだけを操作します。たとえば次のような違いです。
- 低擬人化:「検索結果:この主張を支持する根拠は十分ではありません。出典Aを参照してください。」
- 高擬人化:「私はこの情報ならかなり確かだと思います。気になっているんですね。出典Aも一緒に確認してみましょう🙂」
さらに、擬人化レベルとAI回答の正誤を組み合わせて操作することで、「擬人化が高いと、AIが間違っていても信頼が下がりにくくなるか」を検証できます。どの手がかりが効いているかを特定するには、声・一人称・感情表現を個別に操作する要因計画も有効です。
短期の過信と長期の依存は分けて扱う
短時間の実験だけで「AI依存」を結論づけるのは適切ではありません。長期研究では、割り当てられた会話条件そのものより、自発的な利用量やユーザーの特性のほうが感情的な依存と関連していたという報告もあります。
そのため、短期実験では過信や検証の省略を、数週間以上の縦断研究では反復利用や感情的依存を測る、という段階的な設計が望まれます。
擬人化バイアス研究の倫理:ガイドラインとの関係
この研究は、意図的にAIを人間らしく見せ、一部で誤情報を提示するため、慎重な倫理管理が欠かせません。
日本の「AI事業者ガイドライン」は自動化バイアスや過度な依存、感情の不当な操作への配慮を求めており、UNESCOのAI倫理勧告も擬人化の倫理的影響を評価すべきだとしています。実施にあたっては、次のような配慮が重要です。
- AIであることを明示し、人間を装わない
- 誤情報の刺激は医療・金融・選挙などリスクの高い領域を避ける
- 終了時にすべての誤情報を訂正し、誤った信念が残っていないか確認する
- 「あなたしか話す相手がいない」など関係を独占するような表現は使わない
- 主要な仮説と分析方法を事前登録する
まとめ:擬人化バイアスは「適切な信頼」の設計課題
- 擬人化バイアスは、AIの設計とユーザー側の動機の両方によって強さが変わる
- 声や会話形式などの手がかりは、内容とは無関係に「正しそう」という印象を与える可能性がある
- 一方で、擬人的な言葉だけでは効果が出ない場合もあり、影響は条件次第である
- 評価すべきは信頼の高さではなく、正しいAIを使い、誤ったAIを拒否できるかという信頼校正である
- 検証を促すUIは、擬人化による過信を和らげる可能性がある
今後は、「擬人化 → 検証行動 → 真偽の識別 → 適切/不適切な依存」という行動の連鎖を検証することが、擬人化バイアスの理解を深める鍵になります。特に日本語では、敬語やキャラクター語尾など英語とは異なる言語的特徴があるため、日本語環境に即した研究の価値は大きいといえるでしょう。
コメント