ハルシネーションはマルチモーダル化で減るのか?接地と世界モデルの因果を検証
生成AIの実用化が進むなかで、もっともらしい誤りを出力する「ハルシネーション(幻覚)」は依然として大きな課題です。「AIは世界を見ていないから幻覚を起こす。だから画像や音声を入力すれば解決する」という説明をよく耳にしますが、近年の実証研究はこの単純な図式を支持していません。
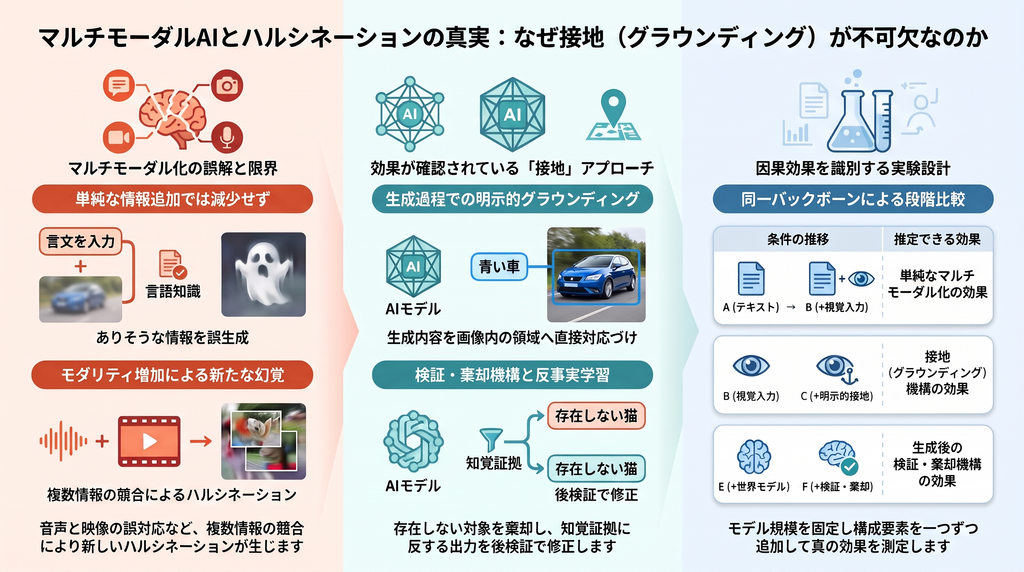
結論から言うと、ハルシネーションの低減に効いているのは「マルチモーダル性」そのものではなく、生成過程で証拠への接地(グラウンディング)を強制する仕組みです。本記事では、ハルシネーションの定義と種類、マルチモーダル化の効果と副作用、効果が確認されている接地機構、世界モデルの可能性と限界、そして因果効果を正しく測る実験設計を順に解説します。
ハルシネーションとは?2種類の幻覚と「接地」の関係
ハルシネーションと一口に言っても、研究上は性質の異なる現象が含まれています。まずは対象を整理しておくことが、対策を考える出発点になります。
事実のハルシネーションと接地のハルシネーション
ひとつは**事実のハルシネーション(factual hallucination)で、現実世界や文書、知識ベースと矛盾する内容を生成するものです。もうひとつは接地のハルシネーション(grounding hallucination)**で、入力された画像・音声・動画・センサー値に存在しない内容を「あるもの」として語ってしまうものです。
前者は主に言語モデル単体で、後者は画像や音声を扱うマルチモーダルモデルで問題になります。両者を「モデル内部の世界表現が参照すべき世界とずれている状態」として統一的に捉える提案もありますが、これはあくまで定義上の整理であり、特定の仕組みを加えれば解決するという実証ではありません。
ハルシネーションを測る主なベンチマーク
事実面ではTruthfulQAやFEVER、視覚面ではCHAIR、POPE、MMHalBench、HaloQuest、HallusionBench、音声・映像の統合面ではAVHBenchやSVHallucなどが用いられています。TruthfulQAの初期研究では、最良のモデルでも真実な回答は58%にとどまり、人間の94%を大きく下回りました。さらにモデルを大きくするだけでは改善しないケースも観察されており、内部知識を増やすだけでは接地の欠如を補えないことを示す初期の手がかりとなっています。
マルチモーダル化だけではハルシネーションが減らない理由
画像や音声を入力できるようにすれば、モデルが参照できる情報は確かに増えます。しかし、情報が増えることと、それを正しく使うことは別問題です。
言語の事前知識に引きずられる問題
複数のベンチマークで、マルチモーダルモデルが画像を入力として受け取っていても、回答生成の段階でそれを十分に利用していない傾向が示されています。たとえば「キッチンの写真」であれば、実際には写っていない冷蔵庫を「ありそうだから」と答えてしまうように、言語的にもっともらしいパターン(言語事前分布)が視覚的証拠を上書きしてしまうのです。
また、生成文が長くなるにつれて視覚情報の影響が徐々に弱まる現象も報告されています。入力時点では画像を正しく認識できていても、出力の後半で接地が失われる可能性があるということです。
モダリティを増やすと新しい幻覚が生まれる
さらに注意すべきは、モダリティの追加が新しい種類のハルシネーションを生む点です。音声と映像を同時に扱うモデルでは、音声で語られた物体や行為を「映像にも映っている」と誤認する現象が確認されています。音声認識そのものは正確でも、モダリティ間の対応づけを誤るわけです。複数視点の画像を扱う場合にも、対象外の視点からの干渉による誤りが指摘されています。
つまり、追加されたモダリティは幻覚の「治療薬」ではなく、あくまで「証拠のチャネルが一本増えた」にすぎません。それを正しく結びつける仕組みがなければ、幻覚はむしろ種類を増やす可能性があります。
ハルシネーションを減らすのは「生成過程での接地」
一方で、外部情報を「入力すること」ではなく、「生成結果をその情報に明示的・継続的に結びつけること」に介入した研究では、比較的一貫した改善が報告されています。
接地の強制・検証・棄却が効く
効果が確認されている主なアプローチは次のとおりです。
- 明示的なグラウンディング:物体検出やセグメンテーションを介して、生成内容を画像内の具体的な領域に対応づける
- 存在しない対象の棄却:誤った前提を含む質問に対し、「その物体は画像にない」と答えられるよう学習させる
- 生成後の検証:知覚的証拠に反する出力を検出し、修正または棄却する
- 反事実データによる選好学習:紛らわしい誤答例と比較させ、証拠に沿った回答を好むよう調整する
重要なのは、これらの比較が同じベースモデルに介入を加えた前後で行われている点です。同じバックボーンでも、接地を強制する設計の有無で幻覚の程度が変わることから、改善の源泉は「画像を持っていること」ではなく「画像を生成過程で使わせる設計」にあると考えられます。
ただし、棄却機構を導入すると「答えなくなったから幻覚が減ったように見える」可能性もあるため、回答率(カバレッジ)と併せて評価することが欠かせません。
幻覚の3つの発生源と原因別の対策
因果メカニズムの分析も進んでいます。近年の研究では、マルチモーダルモデルのハルシネーションを次の3つの要因に分解する試みがあります。
- 視覚的接地の失敗:画像の特徴を正しく捉えられていない
- 言語事前分布の支配:言語的なもっともらしさが視覚的証拠に勝ってしまう
- モダリティ間の競合:複数の情報源が矛盾し、誤った側が採用される
モデル内部の構成要素に個別に介入するアブレーション実験によってこれらの寄与を推定し、原因に合わせて対策を変えると改善が得られたとの報告があります。また、プロンプトに書かれた誤情報が画像の証拠を上書きする際に関与する特定のアテンション機構を無効化すると、幻覚が減少したという制御実験もあります。単純な相関分析よりも強い因果的証拠として注目されています。
世界モデルはハルシネーションを減らすのか?
「世界モデル」という言葉には、LLMが内部に持つ知識や因果の表現という広い意味と、環境の状態遷移を明示的に予測するモデルという狭い意味が混在しています。ここで問題にするのは後者です。
タスク成功率の改善と幻覚率の低下は別物
GUIエージェントやロボットの研究では、環境の遷移則を学習させることで行動の成功率が改善したという報告があります。これは、単なる指示の模倣より状態を踏まえた行動ができるようになることを示唆しています。
しかし、これらの研究の主な評価指標はタスク成功率であり、ハルシネーション率ではありません。成功率の改善には計画立案、探索、表現学習などの効果も含まれるため、それを「幻覚が減った」と同一視することはできません。世界モデルの有無だけを変えて幻覚率を比較した研究は、現時点ではほとんど存在しないのが実情です。
世界モデル自体も幻覚を起こす
さらに、世界モデルは未来の状態を生成するモデルである以上、それ自体が誤った状態遷移を「幻覚」する可能性があります。長期予測で生じた誤った遷移をそのまま学習に使うと方策を誤らせるため、予測の信頼性を評価して低信頼な予測を抑える手法も提案されています。
これは「世界モデルを加えるだけでは不十分で、世界モデル自身の幻覚を検出する仕組みが必要」であることを示しています。また、LLMが高度な計画能力を示すからといって、内部に正確な世界モデルを持つと推論するのは早計だとする研究もあります。
因果効果を正しく測るための実験設計
「マルチモーダルモデルの方が幻覚が少ない」という観察だけでは、因果関係は示せません。モデル規模、学習データ、エンコーダの性能などが同時に異なるからです。因果効果を識別するには、同じバックボーンで構成要素を一つずつ追加する段階的な比較が有効です。
| 条件 | 構成 | 推定できる効果 |
|---|---|---|
| A | テキストのみ | 基準 |
| B | A+視覚入力 | マルチモーダル化の効果 |
| C | B+明示的グラウンディング | 接地機構の効果 |
| D | C+音声・センサー | センサー融合の追加効果 |
| E | D+世界モデル(遷移予測) | 世界モデルの効果 |
| F | E+検証・棄却機構 | 検証機構の効果 |
評価では単一の指標に頼らず、複数のベンチマークを組み合わせることが重要です。加えて、回答の正しさと根拠の正しさを分けて測る、確信度の較正を確認する、複数のシード値で再現性を担保する、評価用LLMの偏りを人手評価で検証する、といった配慮が求められます。世界モデルについては、予測ステップ数ごとに誤差と幻覚がどう蓄積するかを追うことも有効でしょう。
実務で優先すべきハルシネーション対策
以上を踏まえると、実務での優先順位は明確です。まずモダリティを増やすのではなく、接地・誤前提の棄却・反事実データによる学習・証拠を意識したデコーディング・生成後の検証を導入することが、現時点でもっとも根拠のあるアプローチといえます。
世界モデルを活用する場合は、その出力を事実として下流に渡すのではなく、不確実性を伴う仮説として扱い、実際の観測で再検証する閉ループ構成にすることが合理的です。
まとめ
- 「モダリティを増やせばハルシネーションが減る」という単純な因果関係は、現在の実証研究では支持されていない
- マルチモーダル化は情報を増やす一方、言語事前分布への依存やモダリティ間の誤対応という新たな幻覚の原因も生む
- 効果が確認されているのは、生成過程で証拠への接地を強制し、検証・棄却する仕組みである
- 幻覚は「視覚的接地の失敗」「言語事前分布の支配」「モダリティ間の競合」に分解でき、原因別の対策が有効である可能性がある
- 世界モデルはエージェントの行動成功率を改善する有望な手法だが、幻覚率そのものへの因果効果はまだ確立されておらず、世界モデル自体が幻覚を起こすリスクもある
今後もっとも価値が高いのは、同一のマルチモーダルモデルに世界モデルの学習目的だけを追加し、幻覚率とタスク成功率を同時に測る厳密なアブレーション研究です。それによって初めて、世界モデルが「計画を良くするだけ」なのか、「幻覚そのものを減らす」のかを見分けられるようになるでしょう。
コメント