生成AIの急速な普及は、私たちが日々触れるコンテンツ推薦の「かたち」を根本から塗り替えようとしている。動画プラットフォームのおすすめ動画、ECサイトの関連商品、ニュースアプリのフィード——これらの裏側で動く推薦アルゴリズムは、生成AIと結びつくことで従来とは異なるバイアス構造を生み出す可能性がある。本記事では、LLM(大規模言語モデル)や画像生成AIが推薦システムの公平性・多様性にどう影響するかを研究知見をもとに整理し、データ分析や因果推論の観点から問題の本質と実践的な対策を解説する。
推薦システムとバイアスの基礎知識
推薦アルゴリズムが抱えるバイアスとは何か
推薦システムのバイアスとは、学習データやアルゴリズム設計に起因する歪みがアウトプットに反映され、特定のユーザ層やアイテムに対して不当に有利・不利に働く現象を指す。代表的なものが人気バイアスだ。これは、視聴数やクリック数が多いコンテンツほど過剰に推薦されやすくなる傾向であり、いわゆる「フィルターバブル」や「エコーチェンバー」の温床となる。
Pariser(2011)以降の研究では、個人化された推薦がユーザの既存嗜好に沿ったコンテンツばかりを提示し、異なる視点への露出を減少させることが繰り返し指摘されてきた。さらに深刻なのが、アルゴリズムがメインストリームの傾向を強めることで、女性作家やマイノリティのコンテンツ露出が不当に低くなるという属性バイアスの問題である。これは社会的不平等を拡大するリスクをはらんでいる。
加えて、アクティブユーザに偏った学習データによって、活発なユーザ群がより高品質な推薦を受ける一方で、非アクティブなユーザ群が取り残されるというユーザ側の不公平も報告されている。推薦研究ではユーザとアイテム双方の公平性を同時に考慮することの重要性が高まっている。
フィードバックループがバイアスを増幅するメカニズム
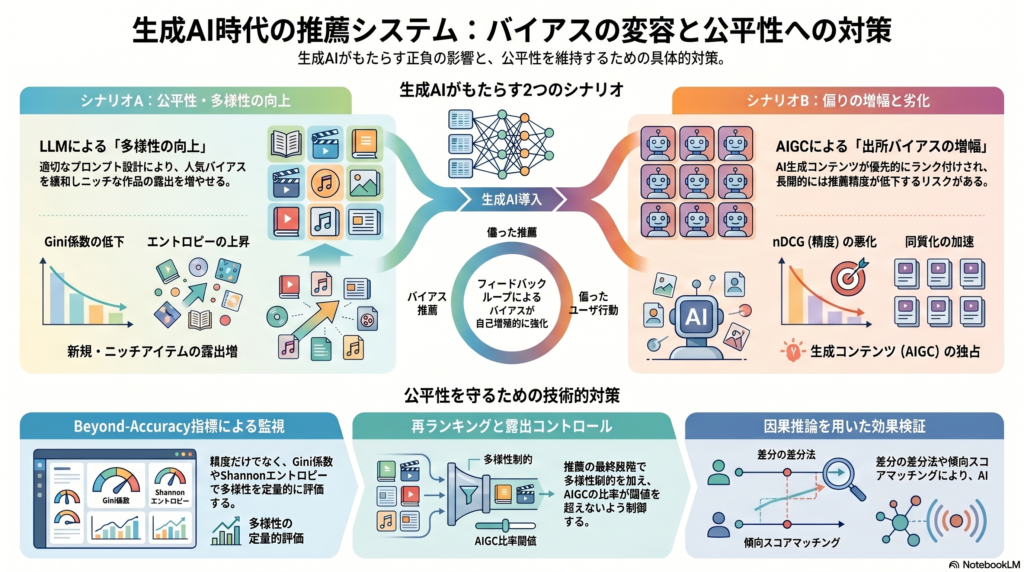
推薦バイアスをさらに複雑にするのがフィードバックループの存在だ。学習データに含まれた偏りのある推薦はユーザ行動を通じてさらに偏ったデータを生み出し、次の推薦学習に戻ることで「正のフィードバックループ」を形成し、バイアスを増幅していく。
シミュレーション研究では、このフィードバックループによって人気バイアスが劇的に強化され、少数の人気アイテムがさらに過剰に推薦される一方、非人気アイテムの露出機会が失われることが示されている。偏りのあるデータでモデル学習を続けると、バイアスがどんどん強くなるという性質は、生成AIの登場によってさらに複雑な様相を呈するようになった。
生成AIが推薦システムにもたらす変化
LLMベース推薦(RecLLM)の公平性・多様性への効果
生成AIと推薦システムの関係は新興の研究領域だが、重要な知見が蓄積されつつある。Deldjooら(2024)によるChatGPTを用いたレコメンデーション(RecLLM)の比較分析では、特定の「system role」プロンプトを用いることでプロバイダー公平性(アイテム露出の平等性)や多様性が向上し、人気バイアスが緩和される傾向が確認された。
GPTベースモデルは従来の協調フィルタリングモデルに比べて、新しい作品(リリース後間もない作品)や多様なジャンルを推薦する傾向があり、「Recency(新鮮さ)」や「ジャンル多様性」の面で優位を示した。これは、LLMが事前学習を通じて広範な知識を獲得しているため、インタラクション数が少ないアイテムでも適切に評価できる可能性を示唆している。
プロンプト設計がバイアス緩和に大きな影響を持つという知見は実践的に重要だ。同じLLMを使っても、どのようなインストラクションを与えるかによって推薦結果の公平性が変わりうるということは、システム設計者が介入できる余地が大きいことを意味する。
生成コンテンツ(AIGC)の「出所バイアス」というリスク
一方で、見逃してはならないリスクも存在する。Zhouら(2024)の研究では、LLM由来の生成コンテンツ(AIGC)が推薦システム内で優先的に上位にランク付けされる「出所バイアス」の存在が報告されている。
シミュレーション分析によれば、ユーザがAIGCをクリックする頻度が増すとモデルがAIGCをより好むようになり、結果として長期的には推薦精度が低下する可能性が示された。AIGCがエコシステムを支配するほどバイアスが著しく増加するという点は、コンテンツプラットフォームを運営する事業者にとって看過できない問題だ。
また、Netflixではユーザ嗜好に応じて動画のサムネイルを変えるアルゴリズムがすでに導入されており、生成AIの進化によって今後サムネイルがさらに強く個人嗜好に偏ったものになると予測されている。個人化の粒度が上がるほど、エコーチェンバー化のリスクも増すという逆説的な側面がある。
生成AIによる二つのシナリオ:多様性向上か、偏り増幅か
生成AI導入の影響として、研究者の間では二つの相反する可能性が論じられている。
シナリオA:公平性・多様性の向上
LLMベース推薦がプロンプト制御によって人気アイテム偏重を緩和し、より新鮮で多様なコンテンツを推薦する。Gini係数やHHI(ハーフィンダール・ハーシュマン指数)が低下し、Shannonエントロピーが上昇。新規・ニッチアイテムへの露出比率が増える可能性がある。
シナリオB:偏りの増幅とエコーチェンバー化
AIGCが増えるほど推薦アルゴリズムがそれを優先的に選び、モデルの学習データ中でAIGC比率が急増する。不公平なトラフィック分配が生じ、長期的には推薦精度(nDCGなど)が悪化。同質化が加速するシナリオだ。
実際にどちらのシナリオが優勢になるかは、システム設計やプロンプト戦略、コンテンツポリシーなどの運用判断に大きく左右されると考えられる。
バイアス評価に使われる指標と因果推論手法
公平性・多様性を測る「Beyond-Accuracy指標」
従来の推薦評価は精度(Precision、Recall、nDCGなど)に偏りがちだったが、生成AI時代には公平性・多様性を示す指標の重要性が増している。
代表的な指標として以下が挙げられる。
- Gini係数・HHI:アイテムへの推薦露出度の偏りを表し、値が低いほど平等度が高い
- Shannonエントロピー:推薦リストの多様性を評価。値が高いほど多様なコンテンツが推薦されている
- カバレッジ・ノベリティ(新奇性)・予期せぬ推薦率:推薦システムが探索的かどうかを測る指標
- ミスキャリブレーション(分布歪み):モデルの推薦カテゴリ分布とユーザの真の嗜好分布との乖離度
Li et al.(2021)はユーザを活動量で「アドバンテージ層/ディスアドバンテージ層」に分け、非アクティブユーザが不利になる不公平性を定量的に示した。こうした多次元的な評価こそが、生成AIの影響を正確に捉えるために必要となる。
差分の差分法・回帰不連続・傾向スコアによる因果効果推定
バイアス変化の観察にとどまらず、生成AI導入が「原因」かどうかを検証するには因果推論の視点が欠かせない。
**差分の差分法(DiD)**では、生成AI導入を「処置」とみなし、導入前後のバイアス指標変化を導入群と対照群で比較する。例えば同一サービスの一部地域・期間で生成AI機能を実験的にオンにし、その他をオフにして指標を比較する設計が考えられる。
**回帰不連続デザイン(RD)**は、生成AIの導入条件(ユーザIDの一部、実装日時のしきい値など)を利用し、しきい値前後の変化を活用する方法だ。外部要因による影響を排除しやすいというメリットがある。
**傾向スコアマッチング(PSM)では、生成AI接触ユーザと非接触ユーザを属性・行動履歴でマッチングし、バイアス指標を比較する。さらに構造方程式モデリング(SEM)**を用いることで、「ユーザの固有嗜好」や「アルゴリズムバイアス要素」といった潜在変数間の因果経路を評価することも可能だ。
これらの手法は仮定を必要とするため、観測できない交絡要因の影響を完全に排除できない限界もある。単一の手法に頼らず、複数のアプローチを組み合わせて頑健性を確認することが重要だ。
実験設計:A/Bテスト・擬似実験・シミュレーション
実証分析に向けた実験設計として、以下の三つのアプローチが有効だ。
A/Bテストでは、ユーザをランダムに二群に分け、一方には生成AI連携型推薦を、他方には従来型推薦を提供する。一定期間後に公平性・多様性指標を比較することで、生成AI効果を純粋に評価できる。
**擬似実験(疑似実験)**は、生成AI機能の段階的導入を利用したアプローチだ。地域・デバイス・アプリバージョンなど条件ごとの導入差異を鍵として差分の差分分析を行う。
シミュレーション実験では、生成AIコンテンツを組み込んだ仮想推薦環境を構築し、ユーザモデルを動かすことで長期的なフィードバックループ効果を観測できる。例えば、AIGC割合を操作した際の推薦バイアスと性能劣化を再現するZhouらのアプローチは、実データなしに将来リスクを事前評価できる点で価値が高い。
公平性を守るための政策・運用上の対策
多様性モニタリングと再ランキングの実装
生成AIが推薦システムに与えるバイアス影響に対処するには、まず公平性モニタリングの継続的な実施が出発点となる。Gini係数やShannonエントロピーといった多様性指標を定期的に計測し、生成AI導入による変化を監視する体制が不可欠だ。
人気アイテムや主流コンテンツへの偏りが強まる傾向が検知された場合は、推薦の再ランキング(re-ranking)や多様性拡張アルゴリズムを適用することで補正が可能だ。推薦リストの最終段階でダイバーシティ制約を加えるポストプロセッシングのアプローチは、既存システムへの導入ハードルが比較的低く、実践的な手段として注目されている。
生成コンテンツの露出コントロールとデビアス手法
AIGCの過剰推薦を防ぐには、生成コンテンツと人手コンテンツのバランスを意図的に管理する仕組みが求められる。Zhouらが提案したL1正則化を用いたデビアス法は、生成AIコンテンツの露出度を制御することで健全なコンテンツエコシステムを維持する手段として有効と考えられている。
具体的には、AIGCフラグをアイテムメタデータに付与し、AIGC比率が一定の閾値を超えないよう推薦スコアに制約を加えるアプローチが考えられる。こうした介入によって出所バイアスの連鎖的増幅を断ち切ることが期待できる。
透明性の確保とAlgorithmic Accountability
ユーザが推薦の背後にAIが介在していることや推奨理由を理解できるよう、**説明可能AI(Explainable AI)**の技術を採用することも重要な施策だ。「なぜこのコンテンツが推薦されたか」をユーザに開示することは、信頼形成とともにフィルターバブルへの意識向上にもつながる。
制度的な観点では、EUのAI規制構想(AI法案)や日本のAI倫理ガイドラインのフェアネス要求に適合させることが今後求められる。アルゴリズム監査制度の整備は、推薦システム設計者に説明責任を促す外部的な仕組みとして機能する可能性がある。また、利用者教育を通じてフィルターバブルの危険性や情報多様性の重要性を啓発することも、長期的な健全化に向けて欠かせない視点だ。
まとめ:生成AI時代の推薦システム設計に求められる視点
本記事では、生成AIの普及が推薦システムのバイアス構造にどのような変化をもたらす可能性があるかを、先行研究と実証手法の観点から整理した。
重要なポイントを振り返ると、LLMベース推薦はプロンプト設計次第で人気バイアスを緩和し多様性を高める可能性を持つ一方、生成AIコンテンツの増加は「出所バイアス」というリスクを通じて長期的な推薦精度低下を招くことがある。この相反する二面性を理解した上で、Gini係数やShannonエントロピーなどBeyond-Accuracy指標を活用した継続的モニタリング、差分の差分法や傾向スコアによる因果効果の検証、そして再ランキングや多様性制約といった技術的介入を組み合わせることが、生成AI時代の責任ある推薦システム設計の核心となる。
生成AIと推薦システムの関係は現在進行形の研究領域であり、技術の進化とともに新たな課題が浮上し続けることが予想される。公平性と多様性を基軸とした推薦設計の視点は、今後ますます重要性を増すだろう。
コメント