導入:なぜ「内発的動機づけと意味づけ」が問われるのか
強化学習(RL)の研究では、外から与える報酬がなくても自ら探索するエージェントを作るために、「好奇心」や「新奇性」を報酬にする**内発的動機づけ(Intrinsic Motivation; IM)**が広く使われています。探索性能が大きく伸びたことで、次の問いが出てきました。こうしたエージェントは環境を「理解」し、意味づけているのか、という問いです。
本記事では、まず「情報」と「意味」の違いを整理します。次に主要アルゴリズムを「意味」の観点から比べ、最新研究の動向、検証のための実験設計と評価指標を順に解説します。
内発的動機づけとは何か:強化学習における基本構造
外的報酬と内発的報酬の組み合わせ
内発的強化学習では、典型的にエージェントが受け取る報酬を次のように表します。 $$r_t = r_t^{ext} + \beta \, r_t^{int}$$
ここで $r_t^{ext}$ はタスクから与えられる外的報酬、$r_t^{int}$ はエージェント内部で計算される内発的報酬です。内発的報酬の作り方によって、探索の性質は大きく変わります。
内発的報酬の5つのタイプ
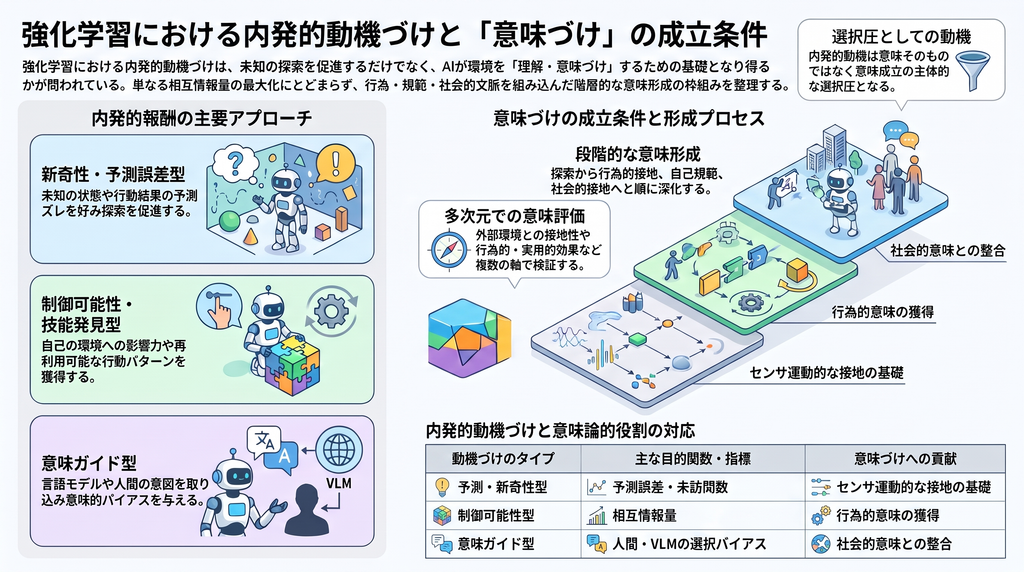
内発的動機づけ研究は、おおむね次の5系統に分けられます。
- 新奇性型:訪問の少ない状態を好む(pseudo-count、RNDなど)
- 予測・知識型:予測しにくい行為結果やモデル間の不一致を好む(ICM、Disagreementなど)
- 制御可能性型:自分が結果をどれだけ制御できるかを重視する(empowerment)
- 技能・相互情報量型:区別可能で再利用できる技能を獲得する(DIAYN、DADS、CICなど)
- 意味ガイド型:言語モデルや人間の意図から意味的なバイアスを取り込む(SENSEI、COLLIEなど)
「情報」と「意味」は何が違うのか
情報量だけでは意味にならない理由
Shannon型の情報量は、不確実性がどれだけ減ったかを測るものです。しかしそれだけでは、「何についての情報か」「その情報がエージェントにとってなぜ重要か」は分かりません。意味論的情報の哲学(Floridi系の議論など)でも、驚きの量と内容を持つ情報は別の問題として扱われます。したがって、相互情報量を最大化しただけで「意味を獲得した」と言うのは、理論的に行き過ぎだと考えられます。
意味づけを構成する6つの次元
意味を検証できる形にするには、意味づけを複数の条件に分けて定義するのが有効です。
| 意味の次元 | 内容 | 観測可能な代理指標の例 |
|---|---|---|
| 接地性 | 内部表現が環境中の対象・属性と安定して結びつく | 真の因子へのprobe、分布外での同一概念識別 |
| 行為的意味 | 何をすれば何が起こるかを区別できる | 介入予測、反事実予測、可制御性 |
| 実用的意味 | 新しい目的に表現を再利用できる | zero-shot / few-shot転移 |
| 規範性 | 自己の状態によって「良い/悪い」が変わる | 内部状態に応じた価値順序の変化 |
| 構成性・抽象性 | 規則・役割・技能としてまとめ上げる | 技能の再結合、階層構造の質 |
| 社会的意味 | 人間の語彙・カテゴリーと対応する | 人間・VLMによるラベル一致度 |
この枠組みは、Harnadの記号接地問題、Barsalouのグラウンデッド認知、目的論的意味論、そしてエナクティビズム(行為的認知)のセンスメイキングを組み合わせたものです。
主要アルゴリズムを「意味」の観点から比較する
新奇性・予測誤差型(RND・ICM・Disagreement)
RNDやcount系の手法は「未知の状態」を見分けるのが得意で、探索が難しいタスクで大きな成果を上げてきました。ただし、対象が何を意味するかや因果関係を直接表すわけではありません。
ICMは自分の行為に関係する特徴空間で予測誤差を計算するため、エージェントが影響を与えられないノイズに引き寄せられにくい設計です。この点で、センサ運動的な接地に一歩近い手法と言えます。Disagreementは複数モデルの不一致を使い、単純な予測誤差よりも確率的なノイズに強い方向を狙っています。
制御可能性型(Empowerment)
Empowermentは、行為と将来の感覚状態とのあいだの情報量を測り、「自分がどれだけ世界に影響を与えられるか」を報酬にします。「自分が制御できるもの」を取り出す性質があるため、行為的意味に比較的近いアプローチだと考えられます。
技能発見型(DIAYN・DADS・CIC)
DIAYNは外的報酬なしで、互いに区別できる技能を獲得します。DADSは予測可能な技能の力学を学び、CICは技能と状態遷移の対照的な相互情報量を最大化して、下流タスクへの適応を改善したと報告しています。
一方で、技能が識別できることと、その技能に意味があることは同じではありません。状態空間を十分にカバーしない問題、単純で学びやすい技能に偏る問題、一つの技能変数に複数の環境要因が絡み合う(entanglement)問題などが指摘されています。
最新研究が示す「意味的探索」への移行
SENSEIとCOLLIEが示した方向性
2025年のSENSEIは、汎用的な情報利得型の内発的探索は低水準の相互作用に偏りやすい、という問題意識から出発しています。そのうえで、Vision-Language Model(VLM)由来の「面白さ(interestingness)」を世界モデルの探索報酬に組み込み、より意味のある行動を見つけることを目指しました。
2026年のCOLLIEは、ガイドのない技能発見がタスクに無関係な技能や危険な技能を生みうる点を問題とし、人間の意図で導ける、意味的に整った技能空間を導入しています。
「強い仮説」と「弱い仮説」
これらの研究から読み取れるのは、次の二点です。
- 強い仮説(否定的):純粋な内発的報酬だけから、高次の意味が必然的に生まれる
- 弱い仮説(肯定的):内発的探索は、意味を獲得するための下地をつくる
つまり「内発的動機 → 意味」という単純な因果関係ではありません。内発的探索が行為可能な構造をつくり、その上に意味的・社会的なバイアスが加わるという階層モデルの方が、既存の知見とよく合う可能性があります。
意味づけを検証する実験設計
シミュレーションと実ロボットの二段階設計
検証の手順としては、因果要因を完全に制御できるシミュレーションで意味指標を確かめ、次に実ロボットで縮小版を再現する二段階設計が合理的です。
- 第一層:色・形・材質・可搬性・危険性などを独立に操作できる、物体中心のグリッドワールド。「見た目が違っても機能が同じ対象」と「見た目が同じでも機能が違う対象」を含める
- 第二層:URLBのような統一ベンチマークで、報酬なしの事前学習から下流タスクへの適応までを評価する
- 実ロボット:把持・押す・積む・開閉などの卓上操作で、「赤い物体」という視覚カテゴリーと「持ち上げられる物体」というアフォーダンスのカテゴリーを分けて検査する
比較条件と5つの仮説
外的報酬のみ、RND、ICM、Disagreement、Empowerment、DIAYN/CIC、ホメオスタシス型内発的報酬(自己維持を報酬とする条件)、意味ガイド型を並べて比較します。検証する仮説は次のとおりです。
- H1:内発的動機づけがある条件は、外的報酬のみの条件より因果因子をよく表現する
- H2:行為に条件づけられた報酬(ICM・Empowermentなど)は、可制御性と介入予測で優位になる
- H3:技能型の目的関数は転移を改善するが、人間のラベルとの対応は自動的には高まらない
- H4:ホメオスタシス型は、内部状態に応じて同じ対象への価値づけを変え、規範性に近い性質を示す
- H5:意味ガイドを加えると人間との整合は高まるが、「純粋に内発的に意味が生まれた」という主張は弱くなる
評価指標と統計解析のポイント
単一スコアではなく「意味プロファイル」で評価する
意味づけを一つの正答率にまとめると、重要な違いが見えなくなります。評価は、接地スコア、因果・行為的接地スコア、転移効率、技能と概念の一貫性、規範性指標(Normativity Index)、人間との整合を並べた多次元プロファイルで示すのが望ましいでしょう。
規範性指標は、同じ外界状態に対する価値 $V(s,h)$ が、内部状態 $h$(エネルギー不足や過熱など)に応じて適切に変わるかを測るものです。これにより、「環境の違い」ではなく「自己との関係で意味が変わる」ことを定量化できる可能性があります。
再現性を担保する統計手法
強化学習は少数のseedの平均値だと結論が不安定になりやすいため、次の点が重要です。
- アルゴリズム・タスク・seedの階層構造を考慮した混合効果モデル
- IQM(四分位平均)、ブートストラップ信頼区間、performance profileの併記
- 内発的報酬以外の条件(エンコーダ、最適化手法、学習予算など)をそろえ、ハイパーパラメータの探索範囲を事前登録する
まとめ:内発的動機づけは「意味が成立するための選択圧」
内発的動機づけは、意味そのものを生み出すというより、意味が成立するための主体的な選択圧を与えるものと捉えるのが妥当です。手法ごとの役割は次のように整理できます。
- 新奇性型:未知を見分ける
- 予測型:自分の行為に関係する未知を見分ける
- Empowerment:自分が制御できる世界を見分ける
- 技能発見型:再利用できる行為パターンをつくる
- ホメオスタシス型:「自分にとって良い/悪い」をつくる可能性がある
- 言語・人間・VLMとの結合:人間が「意味」と呼ぶ水準に近づける
研究の判定基準は「内発的報酬でスコアが上がったか」ではありません。動機の種類を変えたときに、表現が観測の表面から、因果的・制御可能・転移可能・自己関連的な構造へと系統的に移っていくかです。意味づけは単一の報酬から生まれるのではなく、「探索 → 行為的接地 → 自己規範 → 社会的接地」という段階を経て形成される可能性があります。
今後の焦点は、「どの種類の自己生成的な規範が、環境のどの構造を意味あるものとして選ぶのか」という問いへ移っていくと考えられます。
コメント