導入
「窓を閉めてもらえますか?」は形の上では能力を尋ねる疑問文ですが、多くの場面では依頼として働きます。こうした間接的依頼を正しく読み取れるかどうかは、対話AIやチャットボット、カスタマーサポートの意図理解の品質を左右します。
本記事では、まず発話行為分類で間接依頼が難しい理由を整理し、次に多言語での既存研究から見える精度差の傾向、言語ごとの誤分類パターンを紹介します。そのうえで、精度差を安易に「文化差」と結論づけてはいけない理由と、研究・実務で使える評価設計のポイントをまとめます。
間接的依頼の発話行為分類とは?自動分類が難しい理由
文の形と意図がずれる「間接発話行為」
発話行為分類(dialogue act classification)は、発話が「依頼」「質問」「情報提供」「提案」などのどの行為にあたるかを判定するタスクです。Searleの間接発話行為論が示したように、文の形式と発話の働きは一致するとは限りません。
表面の文型に頼る分類器は「Can you…?」を質問(QUESTION)に寄せがちで、本来の依頼(REQUEST)を取りこぼします。間接依頼の自動分類では、文法ではなく語用論的な意図を推論できるかが問われます。
直接・慣習的間接・ヒントの3段階
異文化語用論の代表的な枠組みであるCCSARP系の研究では、依頼表現を大きく3つに分けます。
| 段階 | 例 | 分類の難しさ |
|---|---|---|
| 直接(DIRECT) | 「窓を閉めて」 | 比較的低い |
| 慣習的間接(CONVENTIONALLY INDIRECT) | 「閉めてもらえますか」 | 質問との混同が起きやすい |
| ヒント(HINT) | 「ここ、寒いですね」 | 文脈なしでは情報提供と区別しにくい |
特にヒント型は、室温や直前の会話、聞き手がそれを操作できるかといった文脈がなければ、依頼とも単なる感想とも解釈できます。発話単体の分類では、原理的に正解が一つに定まらないケースがあるという点が重要です。
多言語の発話行為分類で何が分かっているか
同条件で多言語を比べた公開ベンチマークはまだ乏しい
英語・日本語・スペイン語・中国語・アラビア語・ドイツ語について、同じ会話・同じラベル・同じ間接性注釈でモデルを比較した公開ベンチマークは、調べた範囲では確認できませんでした。そのため現状は、性質の異なる複数の研究を組み合わせて傾向を読む必要があります。
MASSIVEに見る言語間転移の差
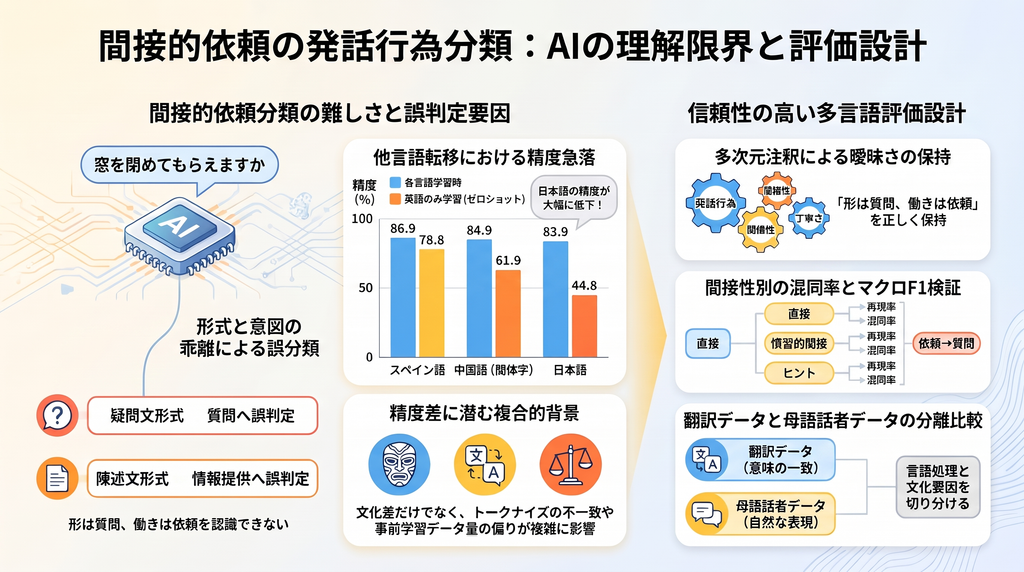
六言語を比較的そろった条件で比べられる資源に、意図分類データセットMASSIVEがあります。英語の発話を多数の言語へ専門翻訳・ローカライズしたもので、XLM-Rによる意図分類の結果は次のように報告されています。
| 言語 | 各言語で学習 | 英語のみで学習(ゼロショット) |
|---|---|---|
| 英語 | 88.3% | — |
| スペイン語 | 86.9% | 78.8% |
| ドイツ語 | 85.7% | 77.6% |
| 中国語(簡体字) | 84.9% | 61.9% |
| 日本語 | 83.9% | 44.8% |
| アラビア語 | 80.7% | 62.8% |
各言語のデータで学習すれば精度は80%台に収まる一方、英語だけで学習して他言語に転移すると、日本語・中国語・アラビア語で大きく低下しています。多言語事前学習モデルであることと、意図がそのまま言語を越えて転移することは別問題だといえます。
ただしMASSIVEは音声アシスタント向けの意図分類であり、間接依頼の精度そのものではありません。また著者らは、事前学習データ量の偏りや、日本語・中国語の文字分割(トークナイズ)の不一致も性能低下の要因として挙げています。
間接化そのものが精度を下げる:IndirectRequests
英語では、同じユーザー意図を直接的な発話と間接的な発話で比べたIndirectRequests(COLING 2025)があります。間接的な言い方に変えると、T5系やLlama-2系のいずれのモデルでも対話状態の推定精度が有意に低下したと報告されています。
これは発話行為分類そのものの結果ではないものの、「間接性」が独立した難しさの要因になることを示す有力な根拠です。
言語別にみる間接依頼の誤分類パターン
典型的な混同:依頼が「質問」「情報提供」に吸われる
間接依頼の誤りはランダムではなく、構造的に起きると考えられます。
- 依頼→質問:「Could you…?」「〜ていただけますか」「可以…吗?」など疑問文の形をとる慣習的間接依頼
- 依頼→情報提供:「寒いですね」のような陳述形のヒント
- 依頼→提案:「〜しませんか」「Why don’t we…?」など提案との境界
- 依頼→その他:主語や目的語の省略で、文脈なしでは意図が復元できない発話
言語ごとに効きやすい要因
- 英語・ドイツ語・スペイン語:助動詞を使った疑問文(Could / Könntest / Podrías)が依頼の典型で、質問との境界が主な誤りの源になりやすいと考えられます。ドイツ語の対話コーパスでは、依頼と提案が細かく分けて注釈されており、両者の混同も論点になります。
- 日本語:敬語や授受表現(〜てもらう/いただく)が、依頼と上下関係を同時に表します。省略も多く、語用論・敬語・トークナイズの影響を分けて検証する必要があります。
- 中国語:「能不能…」「可以…吗」型の疑問文が依頼として機能する一方、親しい相手には直接的な依頼が増える傾向が指摘されています。文末の「吗」を質問の特徴として強く学習すると、依頼の取りこぼしにつながる可能性があります。
- アラビア語:方言差が大きく、単一の言語・文化として扱うこと自体がリスクです。親しい関係では直接的な依頼が親密さの表れと受け取られる場合もあり、「直接的=失礼」という英語中心の前提は当てはまらない可能性があります。
精度差を「文化差」と読んではいけない理由
言語別の精度を並べて「日本語は高コンテクスト文化だから難しい」と結論づけるのは早計です。観測される誤りには、少なくとも次の要因が混ざっています。
- 発話の間接性そのもの
- 社会関係・文化による表現選択の違い
- 敬語やモダリティなど言語ごとの符号化
- 文脈情報の欠落
- 事前学習データ量やトークナイズの偏り
- データセットのドメインやラベル体系の違い
このうち「文化差」と呼べるのは2だけです。たとえば各国の対話コーパスは、列車案内、予定調整、コールセンターなどドメインもラベルも異なり、言語差よりデータセット差の方が大きく効く可能性があります。また依頼の直接性は、言語圏よりも力関係・親しさ・依頼の負担によって変わることがCCSARP系の研究で示されています。
多言語の発話行為分類を正しく評価する方法
依頼を一つのラベルに押し込まない
「発話行為」「間接性」「丁寧さ・緩和表現」「応答(受諾・拒否など)」を別の軸として注釈する多次元的な設計が有効です。これにより「形は質問、働きは依頼」という本質的な曖昧さを、注釈ミスとして扱わずに保持できます。ISO 24617-2系の対話行為注釈とも整合する考え方です。
間接性別のマクロF1と混同率を報告する
全体の正解率だけでなく、直接・慣習的間接・ヒント別の再現率、そして「依頼→質問」「依頼→情報提供」の混同率を言語ごとに示すと、どこで失敗しているのかが見えます。少数クラスを重視するにはマクロF1を主指標にするのが適しています。
翻訳データと母語話者データを分けて比べる
翻訳データは意味内容をそろえやすい反面、元の英語の言い回しを持ち込みます。母語話者が書いたデータは文化的な選択を含みますが、ドメインの偏りが出やすくなります。両方を評価し、その差を比べることで、言語処理の問題と文化的な表現選択を分けて考えやすくなります。
文脈ありモデルと発話単体モデルを比較する
直前の数ターン、話者の役割、場面の状態を入れたモデルと、発話単体のモデルを比較すれば、文脈依存性が性能に与える影響を切り分けられます。
まとめ
- 間接的依頼は、文の形と意図がずれるため、発話行為分類の中でも難しい領域です。
- 多言語モデルは、英語から他言語への転移で言語により大きな精度差が出ることが報告されています。
- ただしその差には、文化だけでなく事前学習の偏り、トークナイズ、ドメインやラベル体系の違いが混ざっています。
- 現時点で「どの言語の間接依頼が何ポイント難しいか」を確定できる統制データはまだありません。
次の一歩として重要なのは、より大きなモデルを試すことよりも、複数言語で同じ会話場面を母語話者が作成し、間接性・社会関係・丁寧さを統一して注釈した並列ベンチマークを整えることです。それによって初めて、言語処理上の課題と文化的な表現選択の影響を分けて測れるようになります。
コメント