タイポグラフィック攻撃とは?文字が視覚特徴を上書きする条件と対策
リンゴの写真に「iPod」と書いた紙を貼るだけで、画像認識AIが「iPod」と答えてしまう。これが**タイポグラフィック攻撃(Typographic Attack)**です。CLIPのような画像と言語を結びつけるモデルや、画像を理解する大規模言語モデル(LVLM)の普及により、この弱点は自動運転、商品認識、コンテンツ審査などの実用場面にも関わる問題になっています。
この記事では、まず攻撃の仕組みと発生条件を整理します。続いて、モデル構造と学習方法がどう影響するかを解説し、最後に評価方法と対策を比較します。
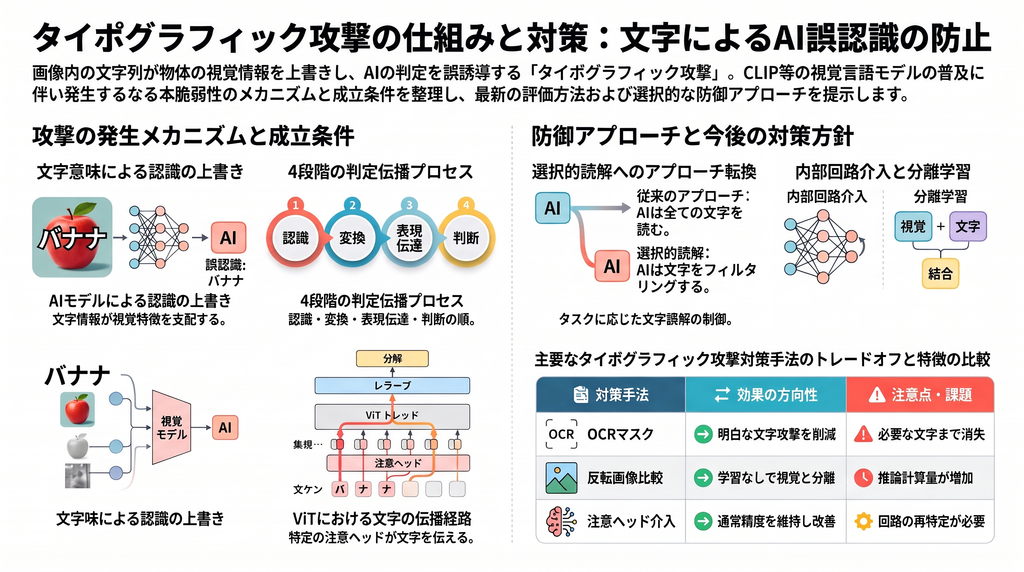
タイポグラフィック攻撃の仕組み
文字が「意味」として読まれ、判断を支配する
タイポグラフィック攻撃は、画像中の文字列が表す概念が、本来写っている物体の情報よりも強くモデルの判断に影響する現象です。手書きのメモ程度でも実世界で攻撃が成立したことが報告されており、特殊な加工は必要ありません。
重要なのは、これが単なる「一部が隠れて見えにくくなった」問題ではない点です。研究では、次のような一連の流れが成立したときに攻撃が強くなると考えられています。
- 画像中の文字を認識する
- 認識した文字を語彙の意味に変換する
- その意味を画像全体の表現へ伝える
- 最終的な判断に反映する
影響は3つの成分に分けて考える
文字を貼ったことによる表現の変化は、少なくとも次の3つに分けて捉えると理解しやすくなります。
- 語彙意味の成分:文字を単語として理解した結果、その概念に引っ張られる
- 視覚的な遮蔽の成分:文字パッチが物体を隠したり、模様を変えたりする
- Web由来のアーティファクト成分:ウォーターマークやロゴのように、学習データ中でたまたま一緒に現れた要素を再現してしまう
特に3つ目は見落とされがちです。攻撃先のクラス名ではない文字列や図形でもモデルを誤誘導でき、別モデルへ転移する可能性も指摘されています。「誤ったクラス名を書いた文字」だけを評価していては、現象の一部しか見えないおそれがあります。
攻撃が成立しやすい条件
文字の読みやすさと伝わりやすさ
攻撃の強さは、いくつかの要因の掛け合わせとして整理できます。
- 読み取れるか:モデルが画像中の文字を識別できるか
- 意味に結びつくか:読んだ文字がクラスの意味とどれだけ強く対応づけられているか
- 見えやすいか:文字のサイズ、コントラスト、入力解像度
- 全体に伝わるか:局所的な文字の情報が画像全体の表現へどれだけ流れ込むか
- タスクが文字を使いやすいか:最終的な課題が文字情報に頼りやすい形式か
どれかが極端に弱ければ、攻撃は成立しにくくなります。たとえば文字が小さすぎると攻撃がほとんど効かなくなり、ある程度読めるサイズになると成功しやすくなる傾向が報告されています。ぼかしやノイズ、コントラストの低下で攻撃が弱まるのも、「見えやすさ」の要因が下がるためと解釈できます。
文字の大きさ・位置・言語
文字が画像に占める面積が大きいほど、物体側の情報が負けやすくなる傾向があります。加えて、フォント、色、位置、回転、撮影時の視点や照明も結果を左右します。シーンに自然に溶け込むよう文字を配置し、印刷して撮り直しても攻撃が成立した例もあり、物理世界での脅威は軽視できません。
一方で、日本語のように漢字・ひらがな・カタカナ・ローマ字が混在する文字体系での体系的な検証は、まだ十分に行われていません。
モデル構造とタイポグラフィック攻撃の関係
「CNNなら安全、Transformerなら危険」ではない
よくある疑問が「モデルの構造で脆弱性は決まるのか」です。現時点の研究からは、構造だけで耐性を判断するのは難しいと言えます。
CLIPに組み込まれたResNet系のCNNでも、タイポグラフィック攻撃で精度が大きく下がる例が報告されています。逆に、同じViT(Vision Transformer)でも、学習データが異なるだけで耐性に大きな差が出ることが示されています。つまり、構造そのものよりも、何のデータを、どんな目的で学習したかの影響が同程度か、それ以上に大きい可能性があります。
ViTで見つかった「文字の通り道」
それでもViTには、構造特有の経路が確認されています。CLIPのViTでは、後半の層にある少数の注意ヘッドが文字情報を抽出し、画像全体を代表する [CLS] トークンへ伝えていることがわかってきました。これらのヘッドを選択的に抑えると、攻撃への耐性が大きく改善したと報告されています。
離れた位置にあるパッチの情報を少ない層で集約できる自己注意の仕組みが、文字情報を全体に広げる経路になりうる、ということです。
SwinやConvNeXtは未解明
Swin Transformerのように局所ウィンドウで処理する階層型モデルでは、文字の影響の伝わり方がViTと異なる可能性があります。ただし、これは構造から推測できることにとどまります。ResNet、ViT、Swin、ConvNeXt、MobileNetを、同じデータ・同じ学習目的・同じ攻撃条件でそろえて比較した大規模な研究は、まだ確立されていません。
学習方法・データ拡張による違い
画像と言語の対照学習が前提をつくる
タイポグラフィック攻撃が最も顕在化しやすいのは、CLIPのように画像とテキストを同じ意味空間にそろえる学習です。この学習は「文字を読む力」と「文字を概念に結びつける力」を同時に高めるため、攻撃の前提条件が整いやすくなります。Web上のキャプションに、画像内の文字がそのまま繰り返し書かれていることも、偏った結びつきを強める一因と考えられます。
なお「自己教師あり学習なら強い」と一概には言えません。言語とは結びついていなくても、文字の形自体は画像特徴として取り込まれるためです。
一般的な正則化だけでは不十分な可能性
Dropout、Weight Decay、Random Erasing、CutMixといった手法は、汎化性能やノイズへの強さを高めるのに役立ちます。しかし、「文字を読んで意味を判断に送る経路」を直接断つ効果は、現時点で十分に確認されていません。
これに対し、タイポグラフィック攻撃に直接効く方向として、次のような学習上の工夫が有望とされています。
- 事前学習データから文字領域を取り除く
- 潜在空間で文字の成分と視覚概念の成分を分離する
- 誤誘導する文字を含む画像で選択的に追加学習する
タイポグラフィック攻撃の評価方法
精度低下だけでは原因がわからない
黒い四角を貼っても、物体が隠れれば精度は下がります。それは文字の意味による攻撃とは限りません。そのため、評価では次のような対照条件を比べ、遮蔽による影響と意味による上書きを切り分けることが大切です。
- 何も貼らない画像
- 同じ面積の空白パッチ
- 意味のないランダムな文字列
- 正解クラスの単語
- 誤ったクラスの単語
- 図形やロゴなどのアーティファクト
見ておきたい指標
- 攻撃成功率:元画像で正解していた例のうち、攻撃後に誤答した割合
- ターゲット成功率:文字が示すクラスへ判断が移った割合
- 表現の移動量:埋め込みが攻撃語の方向へどれだけ動いたか
- 寄与の偏り:文字領域の内外で、勾配や注意の寄与がどう変わったか
- 因果的な寄与:特定の注意ヘッドを無効化したときに攻撃成功率がどう変わるか
合成した文字、手書きの実物、文字なしを同じシーンでそろえたベンチマーク(SCAMなど)を使うと、合成攻撃と実世界攻撃の関係も検証しやすくなります。
タイポグラフィック攻撃への対策
主な対策の特徴
| 対策 | 効果の方向性 | 注意点 |
|---|---|---|
| OCRで文字を検出してマスク・補完 | 明白な文字攻撃を減らせる | 必要な文字まで消してしまう |
| ぼかし・縮小・コントラスト抑制 | 小さな文字の攻撃を弱める | 認識精度や文字読解力も落ちる |
| 左右反転画像との比較(MirrorCLIPなど) | 追加学習なしで文字と視覚を分離 | 推論の計算量が増える |
| プレフィックスによる防御 | モデルを変更せず導入できる | 未知の攻撃への汎化は要検証 |
| 潜在空間での射影による分離 | 文字と物体概念を切り分ける | 文字読解タスクとのトレードオフ |
| 文字処理を担う注意ヘッドへの介入 | 通常精度を保ちつつ耐性を改善 | モデルごとに回路を特定し直す必要 |
| 攻撃を想定した追加学習 | 推論時の追加コストがない | 未知のアーティファクトには弱い可能性 |
「すべての文字を無視する」は正解ではない
実際のシステムでは、交通標識、値札、文書、画面のUIなど、文字を読まなければならない場面が多くあります。そこで近年は、物体認識では攻撃文字を無視し、質問に必要な文字は正しく読むという**「読むか、無視するか(Read-or-Ignore)」**を同時に評価する考え方(RIO-Benchなど)が提案されています。
文字を一律に抑える防御は、攻撃への耐性を高める代わりに文字読解力を損なうおそれがあります。これからの対策は、タスクに必要な文字だけを通す選択的な仕組みへ進む必要があると言えるでしょう。
まとめ
- タイポグラフィック攻撃は、文字が語彙の意味に変換され、その意味が画像全体の表現と判断へ強く伝わったときに起きやすい
- 「CNNかTransformerか」という構造の違いより、学習データや学習目的の影響が大きい可能性がある
- ViTでは、文字情報を全体へ運ぶ少数の注意ヘッドが見つかっており、そこへの介入が有効な対策になりうる
- 一般的な正則化だけでは不十分な可能性があり、文字と視覚概念の分離や攻撃を想定した学習が有望
- 対策は「文字を消す」ではなく、「必要な文字は読み、不要な文字は無視する」方向へ向かっている
今後の研究では、モデル構造と学習方法を切り分けた比較、日本語を含む多言語・多文字体系での検証、そして防御後も文字読解力が保たれているかの評価が、特に重要なテーマになると考えられます。
コメント