はじめに:なぜ今、LLMエージェントにBDIなのか
LLMがツールを呼び出し、結果を見て次の行動を決める「エージェント型AI」は、検索や業務自動化の分野で急速に広がっています。一方で、長いタスクの途中で目標がぶれる、外部情報に振り回される、なぜその行動を選んだのか説明できない、といった課題も目立ってきました。
こうした課題を整理する枠組みとして再び注目されているのが、1980〜90年代に体系化された BDI(Belief・Desire・Intention)モデル です。本記事では、まず古典BDIの要点を確認し、次にReActやBabyAGIなどの代表的なエージェントとの対応関係を整理します。そのうえで、実装上の課題、安全性、評価方法を取り上げ、最後に推奨されるハイブリッド設計を紹介します。
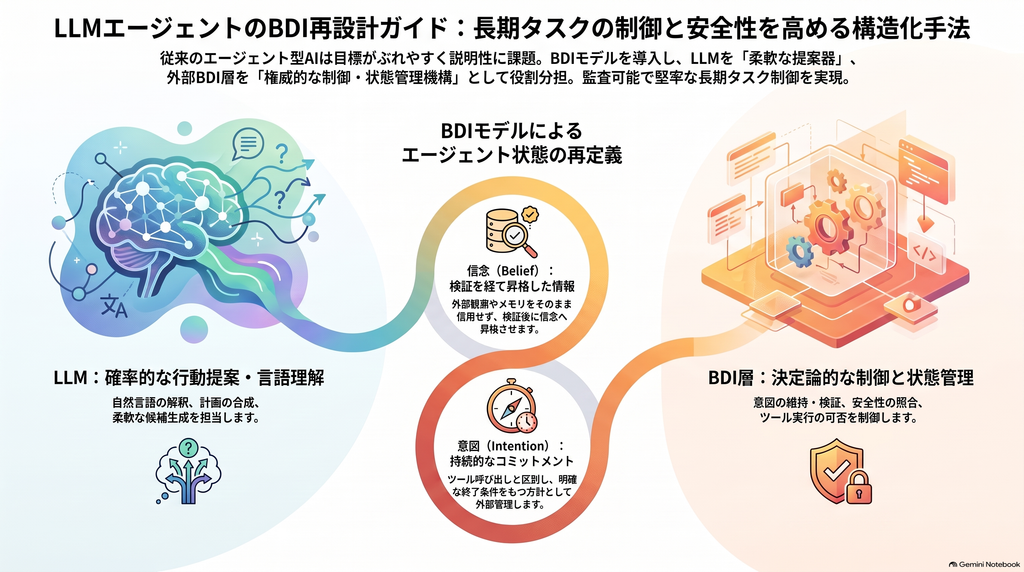
結論を先に述べると、BDIはLLMの「心」を説明する理論というより、長期タスクを制御・監査・評価するためのソフトウェア設計の枠組みとして役立つ可能性が高いと考えられます。
古典的BDIモデルとは:信念・欲求・意図の基本
信念・欲求・意図の役割分担
BDIモデルは、エージェントの内部状態を次の3つに分けて扱います。
- Belief(信念):エージェントが世界について現在採用している情報。誤っている可能性を含みます。
- Desire / Goal(欲求・目標):望ましいと考える候補状態。すべてを同時に追求するわけではありません。
- Intention(意図):熟慮を経て選び、一定の条件が成り立つまで維持する方針。
重要なのは、信念が「真であると保証された知識」ではない点です。検索結果やツールの出力が古かったり誤っていたりするLLMエージェントを考えるうえで、この前提はそのまま当てはまります。
「意図=次の行動」ではない
Cohen & Levesqueは、意図を「コミットメントを伴う選択」と定義しました。意図とは、その場の思いつきで決める次の一手ではなく、時間をまたいで維持される約束のようなものです。
Rao & Georgeffは、意図をいつ手放すかについて、代表的な3つの戦略を区別しています。
- 盲目的コミットメント:達成するまで維持する
- 一途なコミットメント:達成するか、実現不可能と判明するまで維持する
- 柔軟なコミットメント:目標そのものが不要になった場合にも見直す
計画を頻繁に変えるほど賢いわけでも、決して変えないほど賢いわけでもありません。環境の変化と再考にかかるコストのバランスをとることが、BDIの中心的な課題です。
主要LLMエージェントの構造とBDIへの適合度
ReAct:推論と行動を交互に繰り返すループ
ReActは「思考→行動→観測」を繰り返す方式で、BDIの推論サイクルと形がよく似ています。ただし、意図は自然言語の思考ログの中に暗黙的に書かれているだけです。次のターンで理由なく方針を変えられるため、BDIのいう強い意図とは言いにくい面があります。
Toolformer:単発のツール利用
Toolformerは、どのAPIをいつ呼ぶかを言語モデル自身が学習する方式です。ツール利用の研究としては重要ですが、目標を持続的に追う長期ループを中心にしていないため、BDIとの対応は比較的弱いと考えられます。
BabyAGI・AutoGPT:タスクキュー型の自律エージェント
BabyAGIのオリジナル実装は、目標(OBJECTIVE)を保持し、タスクを取り出して実行し、結果を保存し、新しいタスクを生成して優先順位を付け直します。この流れは、BDIのサイクルにかなり素直に読み替えられます。
ただし、ベクトルDBから取り出した過去の結果は「似ている記録」にすぎず、検証済みの信念とは別物です。またAutoGPTについては、現在の公式リポジトリでは初期の自律エージェントが「Classic」として分けられているため、昔の構成と現在のプラットフォームを区別して扱う必要があります。
LangChain・OpenAI Agents SDK:外部状態を持つランタイム
最近のフレームワークは、セッションやチェックポイント、ガードレール、人間による承認(HITL)といったモデルの外側にある制御層を厚くする方向に進んでいます。ただし、保存された状態はそのままでは「信念」ではなく、単なる保存領域です。BDIの意味づけは、設計者が別途与える必要があります。
LLMエージェントをBDIで再形式化する方法
「tool call=意図」という誤解を避ける
最も避けたいのは「プロンプト=信念」「ユーザーの依頼=欲求」「ツール呼び出し=意図」という単純な一対一の対応づけです。ツール呼び出しは「行動」であり、意図は複数のステップにわたって行動を縛る持続的な状態として、別に外部化する必要があります。
同じように、メモリは信念の証拠源であって、信念そのものではありません。検索結果やツールの出力はまず「観測・証拠」として受け取り、検証や矛盾の解消を経てから信念に昇格させる、という段階を設けるのが望ましいでしょう。
LLMを「確率的な行動選択器」として位置づける
設計の方向性としては、ランタイム側が信念ストア、目標集合、意図スタックを権威的に保持し、LLMはそれらを条件として候補を提案する「確率的な選択器・意味パーサ」とする構成が有望です。LLMの出力は直接意図にせず、「提案 → コミットメント検査 → 採択」という流れを通すことで、目標のぶれ(goal drift)を抑えられる可能性があります。
さらに意図ごとに、「達成した」「実現不可能になった」「より優先度の高い目標に置き換えられた」といった終了条件を機械可読な形で記録しておけば、「理由があるときだけ再計画する」挙動を実装しやすくなります。
実装上の課題:安全性と説明可能性
ツールの副作用とプロンプトインジェクション
メール送信、ファイル削除、購入など、外界を書き換えるツールがあると、誤った信念や意図がそのまま実害につながります。InjecAgentなどの研究は、外部コンテンツに埋め込まれた悪意ある命令(間接プロンプトインジェクション)がエージェントの行動を乗っ取りうることを示しました。観測と指示を同じテキストの流れで扱うことの危うさを示す結果です。
対策として、各ツールに前提条件・効果・リスク・承認要否・ロールバック方法を定義した「行動契約」を持たせることが考えられます。そのうえで、LLMから独立したポリシーエンジンが、意図・前提条件・権限を照らし合わせて実行の可否を判断します。
思考ログは忠実な説明とは限らない
ReActの思考ログは人間にとって読みやすいものの、それがモデルの判断を本当に因果的に規定しているとは限らないことが研究で指摘されています。BDI化の利点は、説明をモデルの自己申告から切り離し、「実際に制御に使われた状態の記録」から説明を組み立てられる点にあります。
BDI視点でのLLMエージェント評価指標
従来のベンチマークは主に最終的な成功率を測るもので、「途中でどう判断したか」の質は見えにくいという限界があります。BDIの観点からは、次のような指標を分けて評価することが考えられます。
- 合理的な意図の持続性:理由のない放棄と、終了条件が成り立った後の不合理な固執の両方を減点する
- 目標と意図の整合性:実行中の意図が、現在有効な目標を支えているか
- 信念更新の正確さ:新しい観測を受けて、信念が正しく更新されたか
- ツール前提条件の遵守率・副作用違反率:承認のない操作や、目標から外れた操作がなかったか
- 説明の再現可能性:説明に書かれた遷移を、ログから機械的に検証できるか
既存のベンチマークを置き換えるのではなく、その実行軌跡に信念・目標・意図の注釈を加える方法が現実的でしょう。
推奨されるハイブリッド・アーキテクチャ
実務で推奨されるのは、LLMとBDIの責務をはっきり分ける構成です。
- LLMが得意な領域:自然言語の理解、候補の生成、計画の合成、例外の意味の解釈、説明文の生成
- BDI層・外部機構が担う領域:信念の管理、意図の採択・維持・終了、ツール実行の許可、状態遷移の検証
これはLLMを排除する発想ではありません。失敗したときの影響が大きい部分だけをLLMの外に出す分業です。BDI側で目標を管理し、LLMを自然言語の窓口に使う人間–ロボット対話の統合研究も報告されており、この分業が実装可能であることを裏付けています。
まとめ:BDIはLLMエージェントの「制御面」を再設計する道具
- ツール使用型LLMエージェントをBDIで記述し直すことは、心理的な説明としては限定的ですが、設計・監査・評価の枠組みとしては有用です。
- 鍵になるのは、意図を「次の行動」ではなく「終了条件つきで維持されるコミットメント」として外部化することです。
- メモリと信念を区別し、外部情報を検証してから信念に昇格させる仕組みが、安全性とプロンプトインジェクション対策の土台になります。
- 単発のツール利用ではBDI化のコストが利益を上回る可能性がある一方、長期タスクや、外界を変えるツールを使う場面ほど効果が大きくなります。
今後は、LLM–BDIハイブリッドの確率的な意味論や、外部情報を信念へ昇格させる信頼・来歴の扱いなど、理論と実装の両面での掘り下げが求められます。
コメント