はじめに:なぜ今「シンボルグラウンディング問題」が重要なのか
画像を見て説明し、質問に答え、対象を指し示すAIが当たり前になりました。こうしたAIは「言葉の意味を本当に理解しているのか」という古典的な問いに、改めて実践的な形で向き合っています。それがシンボルグラウンディング(記号接地)問題です。
本記事では、まず問題の定義を確認し、主要な視覚・言語モデル(VLM)の仕組みを整理します。次に、接地を複数の階層に分けて到達度を評価し、ベンチマークの落とし穴と今後の研究方向を解説します。
シンボルグラウンディング問題とは?Harnadの定義をわかりやすく解説
記号が記号を定義する「辞書の循環」
シンボルグラウンディング問題は、認知科学者Stevan Harnadが1990年に定式化した問いです。記号の意味を、外部の人間の解釈に頼らずに、システム自身のものにするにはどうすればよいか、という問題です。
Harnadは、中国語を知らない人が中国語―中国語辞典だけで言葉を学ぼうとする例を挙げています。未知の記号を別の未知の記号で説明するだけでは、いつまでも意味にたどり着けません。
Harnadが示した解決の方向性
Harnadは、記号をボトムアップで感覚に結び付ける構想を示しました。
- アイコニック表象:感覚入力そのものに対応する表象
- カテゴリー表象:経験から不変的な特徴を抽出し、対象を判別する表象
- 記号的合成:接地された基本記号を組み合わせて高次の意味を作る
ここで重要なのは、Harnadがカメラ像のような「対象との因果的なつながり」だけでは不十分だと考えていた点です。対象を弁別し、同定し、操作し、記述するという幅広い行動能力が必要であり、感覚運動的な接地も重視されていました。
視覚・言語モデル(VLM)はどう進化してきたか
CLIP・ALIGN:画像と言葉を同じ空間で結び付ける
CLIPとALIGNは、大量のウェブ画像とテキストの組を使い、対応する画像と文章が近づくように学習(対照学習)するモデルです。自然言語で視覚概念を指定し、学習していないタスクにも転移できる点が大きな特徴です。Harnadの「名前を非記号的なカテゴリー表象に結び付ける」構想に、機能面ではかなり近いと言えます。
BLIP・Flamingo・PaLI:画像から言葉を生成する
BLIPは、視覚情報を言語表現に注入する仕組みと、画像からキャプションを生成するデコーダを組み合わせました。「同じ空間で近づける」段階から、「視覚入力が言語生成を拘束する」段階への前進です。
Flamingoは画像とテキストが交互に並ぶ入力を扱い、少数の例示だけで質問応答などをこなします。一方で論文自身が、対話の中で画像に根拠のない推測が生じる場合があると認めています。言語知識は接地を助ける一方で、視覚証拠を上書きしてしまう可能性もあるのです。
Kosmos-2・GPT-4o:領域指示とマルチモーダル統合
Kosmos-2は、テキスト中の語句と画像内の領域(バウンディングボックス)を直接対応させる学習を取り入れ、「どれを指しているか」を明示的に扱えるようにしました。
GPT-4oは、テキスト・画像・音声などを単一のモデルでエンドツーエンドに扱うと公式に説明されています。ただし内部構造の詳細は公開されていないため、能力は評価できても、接地の仕組みを研究的に検証するには制約があります。
PaLM-E・RT-2:知覚から行為へ踏み出すVLA
PaLM-Eは画像やロボットの状態をモデルに入力し、操作計画を扱います。RT-2はロボットの行動を言語と同じようなトークンとして出力するVision-Language-Action(VLA)モデルです。ウェブ由来の知識をロボットの行動へ転移できる可能性を示した点で、静的なVLMとは質的に異なる一歩です。
接地の6階層で見るVLMの到達度
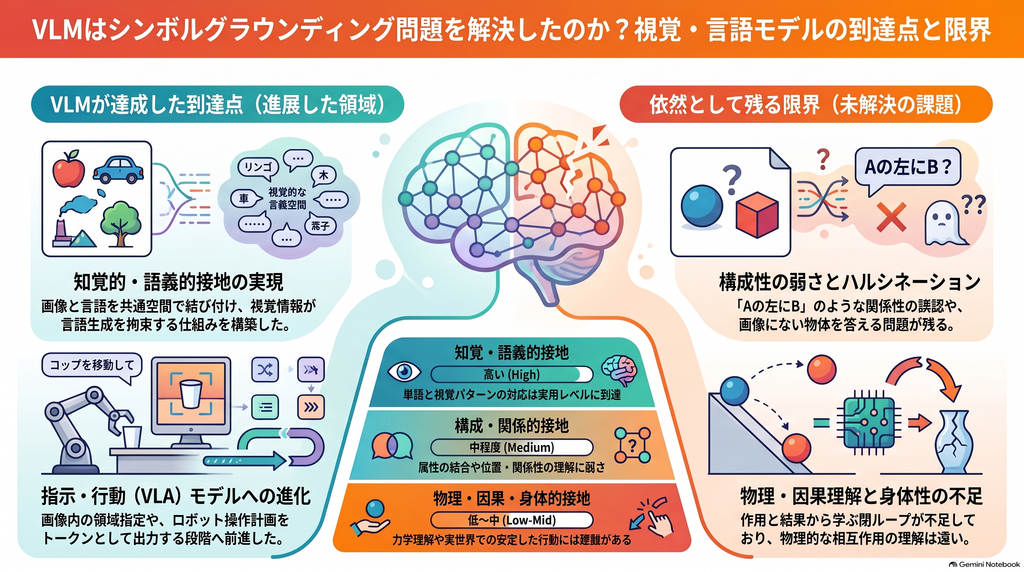
「解決した/していない」の二択では実態を捉えきれません。接地を階層に分けると、強い部分と弱い部分がはっきり見えてきます。
| 接地の階層 | 現状の評価 | ポイント |
|---|---|---|
| 知覚・語義的接地 | 高い | 単語と視覚パターンの対応は広く実現 |
| 指示的接地 | 中〜高 | 明示的な領域学習で強化されるが、混雑した場面などで不安定 |
| 構成・関係的接地 | 中程度 | 属性の結合や語順、関係の理解に弱さ |
| 画像への忠実性 | 中程度 | 見えていないものを答える幻覚(ハルシネーション)が残る |
| 物理・因果的接地 | 低〜中 | 力学や因果、反事実の理解に大きな課題 |
| 行為・身体的接地 | 通常VLMは低、VLAで部分的 | 低レベルの操作制御が特に難しい |
知覚的接地は大きく前進した
純粋なテキストモデルと違い、VLMの出力は画像の内容によって実際に変わります。この点で、辞書の循環に閉じた記号系とは本質的に異なり、知覚的な接地は実用レベルに達したと言えます。
構成性と幻覚が残る弱点
一方で、同じ単語を使いながら関係だけが違う文(「赤い箱が青い球の左」と「青い球が赤い箱の左」など)の区別には弱さが見られます。また、言語上よく一緒に出てくる物体を、画像に存在しないのに答えてしまう傾向も報告されています。
物理・因果と身体性はまだ遠い
「重い」「滑る」「ぶつかる」といった概念は、見た目だけでなく、介入とその結果の規則性に結び付いています。物理・因果を問うベンチマークや、具身エージェントの評価では、言葉で計画を述べることと、実際に安定して行動することの間に大きな差が残っています。
ベンチマークの落とし穴:高い正答率は接地の証拠になるか
言語のショートカット問題
初期の視覚質問応答(VQA)では、画像を見なくても質問文の統計的な偏りだけでかなり正解できることがわかりました。そこでVQA v2は、同じ質問でも答えが変わる画像の組を導入し、VQA-CPは訓練時と試験時で回答の分布を変えて、モデルが偏りに頼っていないかを確かめました。
評価は「正答」から「根拠」へ
その後、関係推論や一貫性を測るGQA、構成性を問うWinogroundやARO、ベンチマーク自体の言語的な偏りを除いたSugarCrepe、幻覚を直接測るPOPEなどが登場しました。研究の関心は「答えられるか」から「正しい視覚的根拠で答えたか」へと移っています。
必要なのはアブレーションと反事実テスト
接地をより確かに評価するには、次のような視点が有効と考えられます。
- 画像を隠したりシャッフルしたりすると性能が下がるか
- 対象物だけを入れ替えたとき、答えが適切に変わるか
- 無関係な背景を変えても、答えが変わらないか
- 正しい領域を指し示せるか
主要な反論とその検討
「画像を入力すれば接地は完了している」
弱い意味の接地については、おおむね正しい見方です。ただしHarnadの基準では、感覚像とつなぐだけでは不十分で、カテゴリーの行動的な同定や感覚運動的な接地まで求められます。VLMは問題を回避したのではなく、Harnadが求めた非記号層の一部を実際に構築した、と捉えるのが適切でしょう。
「データを増やせば世界モデルになる」
データの量と質が重要なのは確かです。しかし物理的な性質の理解については、学習データに物理知識が乏しいことが弱点の一因とされており、規模の拡大だけで解決するとは限りません。
「意味はモデル自身に宿っているのか」
Harnad自身、完全な行動能力を示しても、それが主観的な意味を保証するわけではないと述べています。この哲学的な問いは、ベンチマークの点数だけでは決着しません。そのため、「どの環境要因が出力を実際に拘束しているか」を測るほうが、科学的には生産的だと考えられます。
今後の研究方向:閉ループで接地を評価する
次の前進は、画像とキャプションをさらに大量に学習することだけからは生まれにくいと考えられます。鍵となるのは、次のような閉ループです。
見る → 仮説を立てる → 行為する → 世界が変化する → 感覚フィードバックを得る → 記号の意味を更新する
具体的には、学習前に意味を持たない新しい語を使った語義獲得実験、物体を押したり持ち上げたりして初めて性質がわかる身体的概念の獲得実験、複数のエージェントが協調しながら独自の記号を作る実験などが考えられます。最後の方向性は、日本の記号創発ロボティクス研究が重視してきた「経験と相互作用から記号体系が形成される過程」とも重なります。
まとめ
- VLMは知覚的・機能的な接地を大きく前進させた:言葉が画像の視覚的な規則性によって実際に制約されるようになった
- 指示的接地は進展したが、構成性と分布シフトへの頑健性は未完成:関係や属性の結合、幻覚に課題が残る
- 物理・因果、行為・身体的な接地は未解決:VLAは重要な橋渡しだが、実世界での安定した行動にはまだ距離がある
- 「意味がシステムに内在するか」は未決着:点数の向上やモデルの大規模化だけで答えが出る問いではない
まとめると、視覚・言語モデルはシンボルグラウンディング問題を知覚的・機能的なレベルではかなり緩和しましたが、関係・因果・身体・自律的な記号形成まで含む一般的な接地問題は、依然として未解決です。今後は、介入と帰結を含む閉ループの評価と、身体性・社会性を取り込んだ記号形成の研究が、次のテーマとして掘り下げる価値が高いと考えられます。
コメント