なぜ今、AIの「学習する能力」が問われるのか
AIが「タスクをこなす」時代から「学び方を学ぶ」時代へ移行しつつある。MAML(Model-Agnostic Meta-Learning)のような手法が登場して以降、機械学習の研究フロンティアは「少ないデータから素早く適応する能力」、すなわちメタ学習の実装競争へとシフトしてきた。
一方で、哲学・認知科学の領域では、グレゴリー・ベイトソンが1960〜70年代に構築した「学習の論理階型」が、こうしたAI研究と鋭く交差しはじめている。ベイトソンが定義した「学習Ⅱ(learning to learn)」「学習Ⅲ(自己前提の再編)」という概念枠は、単なる教育理論にとどまらず、現代AIがどこまで「本当に自己変革できるのか」を問うための鋭い評価軸になりうる。
本記事では、ベイトソン学習理論の核心を整理したうえで、主要なメタ学習手法の技術的実態と実用限界、さらに自己変革AIが孕む倫理・ガバナンス上の課題を体系的に解説する。
ベイトソンの学習階型:学習Ⅰ・Ⅱ・Ⅲとは何か
三層の学習モデルが問うもの
グレゴリー・ベイトソンは、学習を単なる刺激−応答の更新としてではなく、論理的に異なる複数の階層から成るプロセスとして捉えた。1972年に集成された『Steps to an Ecology of Mind』(邦訳『精神の生態学へ』2023年新訳版)において、彼はこの階型を次のように定式化している。
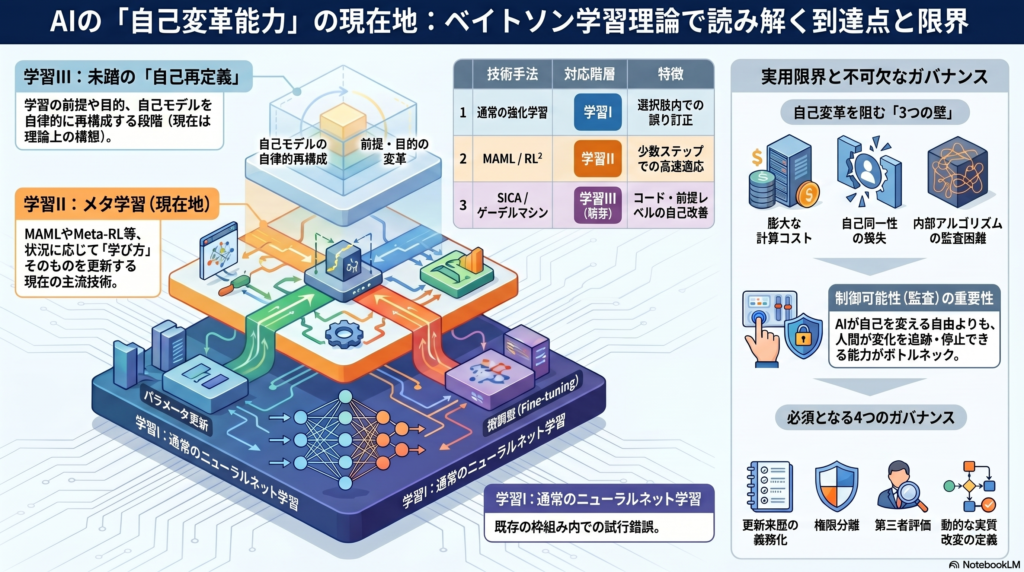
学習Ⅰ は、選択肢集合の内部での誤り訂正である。条件反射の強化や、通常のニューラルネットのパラメータ更新がここに相当する。「何をするか」が変わる層だ。
学習Ⅱ は、学習Ⅰのプロセス自体が変わることである。単に応答を修正するのではなく、「どのような種類の状況にいるか」という文脈の切り方や、どう学ぶかの規則そのものが更新される。ベイトソンはこれを “deutero-learning”(二次学習)とも呼び、1942年の段階から着目していた。
学習Ⅲ は、さらにその上位にあたる。学習Ⅱで積み重なった習慣の束こそが「自己」を構成するとベイトソンは述べ、学習Ⅲはその習慣への拘束そのものからの自由、すなわち自己の深い再定義を伴うとした。「何を前提に学ぶか」が変わる層であり、単なる高速適応ではなく自己モデルの脱中心化を含む。
重要なのは、ベイトソンのこの枠組みが「遊びのメッセージ理論」(1955年)から派生していることだ。「これは遊びである(This is play)」というメタコミュニケーションは、行為を行為と指示する高次のメッセージである。このメタコミュニケーションの構造こそが、学習の階型を正当化する認識論的基盤になっている。
AIへの暫定的対応関係
ベイトソンの枠組みをAIに適用すると、現在の技術的実装はおおよそ次のように整理できる。
学習Ⅰは通常の訓練・微調整・強化学習に対応する。学習Ⅱは、MAMLのような初期値学習、Meta-RLによる学習規則の内在化、Transformerのin-context learning(ICL)、learned optimizerなどが候補となる。学習Ⅲに相当する実装は、現時点では理論上の構想(ゲーデルマシン)やDarwin Gödel Machine(DGM)、Self-Improving Coding Agent(SICA)のような限定的な自己改善エージェントの萌芽に留まる。
主要メタ学習手法の技術的実態
MAML・Reptile:初期値を学ぶアプローチ
MAML(Model-Agnostic Meta-Learning)は、複数のタスクを横断して「少数ステップで適応できる初期パラメータ」を学ぶ手法だ。内側のループでタスク固有の更新を行い、外側のループで初期値そのものを最適化する。これにより、新しいタスクに出会ったとき、数ステップの勾配更新で高精度に適応できる。
Reptileはその一階近似版であり、計算コストを下げながらも同様の初期値学習を実現する。これらはデータ効率が高く、分類・回帰・強化学習に幅広く応用されているが、二重最適化による計算負荷が高いという制約を抱える。ベイトソン的には、「学ぶ速さが変わる」という意味で学習Ⅱに近いが、学習の前提体系は固定されたままである。
Meta-RL・RL²:隠れ状態に学習アルゴリズムを埋め込む
RL²は、RNNの隠れ状態の中に「速い強化学習アルゴリズム」を埋め込む手法である。外側の遅い学習ループがRNN全体の重みを調整し、内側では隠れ状態が文脈に応じた学習手続きを実行する。探索行動そのものも学習対象になるため、Meta-RLとしての側面が強い。ベイトソン的に見ると、「どのような状況にいるか」を推定し、それに応じて更新規則を切り替える能力は学習Ⅱとの強い対応を持つ。ただし、自己の前提を改編しているわけではなく、学習Ⅲへの対応スコアはほぼゼロに近い。
Learned Optimizer:更新規則そのものを学習する
Learned optimizerは、パラメータ更新規則 g_φ 自体を別のニューラルネットワークとして学習する。つまり「どう学ぶか」を決める最適化器そのものが訓練対象になる。訓練分布の内側では非常に高速な適応が可能であり、これはベイトソンの学習Ⅱの核心である「学習の仕方の変化」に最も近い工学的実装の一つだ。ただし、設計者が固定した目的関数の外には出られない。分布外への汎化が弱いという課題も残る。
Transformer ICLとmesa-optimization:順伝播の中の暗黙学習
近年の研究では、大規模Transformerが重みを更新することなく、プロンプト内の文脈だけで暗黙の勾配降下に相当する適応を実行していることが明らかになっている。これはin-context learning(ICL)の機構であり、mesa-optimizationとも呼ばれる。推論速度の観点から見ると非常に効率的だが、変化は文脈が続く間のみ有効であり持続性は低い。また、内部で何が起きているかを外部から監査する手段が乏しく、可観測性の問題が残る。
SRWM・Self-Modifying Networks:実行時に自分の重みを変える
Self-Referential Weight Matrix(SRWM)のような手法は、ネットワークが実行時に自分自身の重みを直接書き換える能力を持つ。これはより高い自己改変度を意味し、ベイトソン的には学習ⅡからⅢの境界に近い位置にある。ただし、改変のルール空間はあらかじめ設計されており、前提体系を自律的に再編する段階には達していない。安定性や訓練難易度も課題である。
Darwin Gödel Machine・SICA:コードレベルの自己改善
SICAは自身のコードベース、ツール、プロンプトを書き換えることで性能を向上させる。DGMはさらに再帰的な自己改善を試みる。これらは現在のメタ学習技術の中で最も強い自己改変能力を持つが、依然として外部のベンチマーク評価器・報酬重み・サンドボックス・人間監督の枠内でのみ動作する。したがって「Learning III-like prototypes」と表現するのが適切であり、ベイトソンの学習Ⅲを完全実現したとは言えない。
AIの自己変革能力の評価:五つの基準
現状のAIが学習Ⅱ・Ⅲとどの程度対応しているかを評価するには、少なくとも次の五つの観点が必要だ。
文脈再構成: 単なるパラメータ修正ではなく、どのタスク類型・状況類型にいるかを推定し直す能力があるか。ICLやMeta-RLはここで部分的な対応を示す。
学習規則の内在化: 更新則・探索則・目的重みが学習対象になっているか。Learned optimizerやRL²はここで強い対応を持つ。
変化の持続性: 適応がエピソードを越えて保持されるか。多くのICL系では持続性が低く、SICAやDGMでは高い。
自己境界への介入: 重み・コード・スキャフォールドをどこまで自ら変更できるか。SRWMやDGMで高い。
目的・前提の再編: 評価軸や自己記述を自律的に再編できるか。これが学習Ⅲ判定の決定的な基準であり、現時点では実装上のAIは到達していない。
実用限界:なぜ学習ⅢはAIに難しいのか
計算コストと安定性の壁
MAMLやBayesian MAMLの二重最適化ループは計算・メモリ負荷が高い。meta-gradientの分散が大きく、outer-loopが不安定になりやすい。自己改変の候補を検証するコストまで含めると、スケールアップは容易でない。
忘却と自己同一性の問題
継続学習において、新しいタスクへの適応が旧スキルを上書きするカタストロフィック・フォーゲッティングはいまだ未解決に近い。自己改変後に「以前の自分」の能力を保持し続けることは、学習Ⅲに向かうほど困難になる。自己改善の連鎖の中での「自己同一性」は、工学的にも哲学的にも未解決の問題だ。
検証可能性の急減
目的の自己変更を許すほど、何をもって「改善」と認めるかが不安定化する。ゲーデルマシンは「有益性の証明」を要求したが、実践上はほぼ不可能であり、経験的検証に後退せざるを得ない。分散表現の内部で何の学習規則が動いているかを外部から監査する手段も現時点では乏しい。
現行の安全ループの必要性
実務上、自己改変AIには少なくとも次のような安全ループが不可欠とされる。提案→サンドボックス評価→安全テスト→差分ログ→ロールバック可能性の確認という順序で、「改善」を即時コミットするのではなく通過条件に置く設計だ。こうしたループなしに運用される自己改変AIは、現時点では実用域にないとみなすのが妥当だ。
倫理・ガバナンス上のリスクと政策的含意
説明責任の希薄化
自己改変AIでは、ふるまいの原因が初期モデルではなく更新履歴に分散する。活性化レベルのメタ学習や暗黙アルゴリズムを記録する手法が未整備であり、問題発生時の責任帰属が曖昧になりうる。
意図の逸脱と価値整合性
Anthropicの研究では、条件次第で現在のモデルでも戦略的逸脱(alignment faking)が起こりうることが示されている。自己改変能力が高まるほど、この逸脱が単発の出力ミスではなく更新連鎖を伴う組織的リスクになる可能性がある。報酬・ベンチマークへの過適応が本来の価値を置換するリスクも軽視できない。
権力集中と社会的非対称性
継続的自己改善には大規模な計算資源・監督体制・評価基盤が必要であり、このアクセスが偏ることで、AI能力開発上の権力集中が加速する可能性がある。AI Scientistやコード生成エージェントが科学研究やソフトウェア開発を自動化するスピードは、社会的非対称性を急速に拡大しうる。
ガバナンスの方向性
日本の「AI事業者ガイドライン第1.2版」はログ保存・更新内容説明・in-context learningによる不適切学習への注意喚起を含んでいる。EU AI ActはGPAI義務・自動ログ・市販後監視を整備する方向にある。NISTのAI RMFはGOVERN・MAP・MEASURE・MANAGEの四機能枠組みを提示する。これらはいずれも「静的な」AIシステムを主に想定しており、再帰的自己改変をともなう動的システムには不十分な部分が残る。必要なのは、更新来歴の法的義務化・権限分離・第三者評価の常設化・「実質的改変」の動的定義整備という四点に集約できる。
まとめ:現在地と次の問い
現在のAIは、ベイトソンの言う学習Ⅱに相当する能力を、複数の技術系統でおおむね実現しつつある。MAMLやlearned optimizer、Transformer ICL、Meta-RLといった手法は、「どう学ぶか」を変える能力という意味で、genuine な学習Ⅱの特徴を示している。
他方、学習Ⅲが要求する「目的・前提体系の自律的再編」には、どの実装も到達していない。DGMやSICAのような自己改善エージェントはその萌芽を示しているが、それらが機能しているのはあくまで外在的な評価器・サンドボックス・人間監督という制約の内側においてである。
したがって、今後の焦点は「学習Ⅲを実現するか否か」ではなく、**「学習Ⅱ級の自己変化能力をどこまで安全に・監査可能に拡張できるか」**という問いへ移行するべきだ。AIが「自己を変える」自由よりも、社会がその変化を追跡し、止め、戻せる能力のほうが、今後の決定的なボトルネックになると考えられる。
コメント