はじめに:なぜVR・AR・AIには専用のUX尺度が必要なのか
VR・AR・没入型体験や、対話型AI・生成AI・意思決定支援AIの普及に伴い、「その体験は本当に良いのか」を客観的に示す重要性が高まっています。一方で、従来のユーザビリティ尺度をそのまま流用すると、プレゼンスやVR酔い、AIへの過信といった技術固有の問題を見落とす可能性があります。
本記事では、まず既存UX尺度の強みと限界を整理します。そのうえで、領域ごとにカスタマイズした尺度の設計思想、検証の進め方、実装時の注意点を順に解説します。
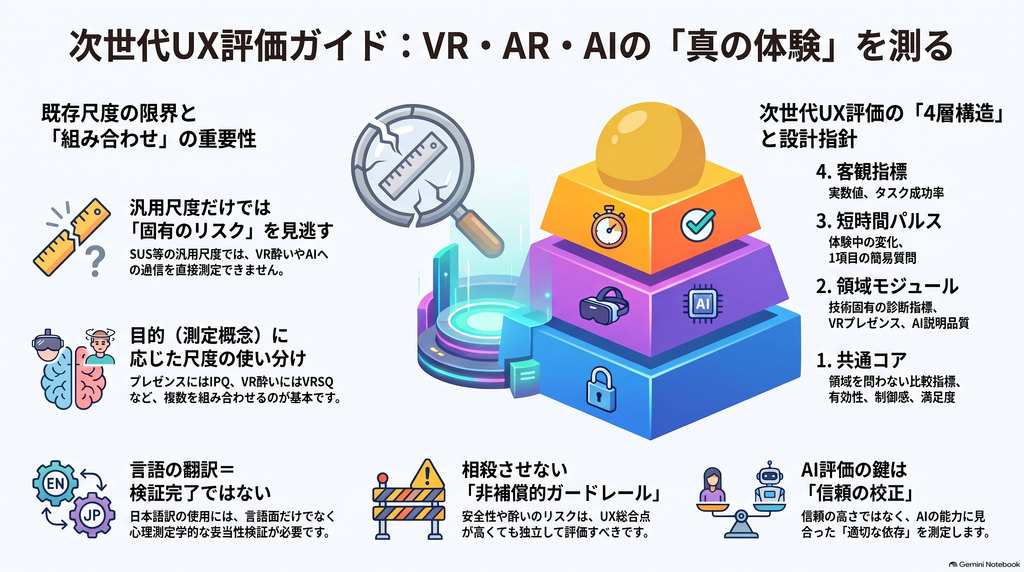
既存UX尺度の強みと限界
「一つの尺度ですべてを測る」ことの難しさ
VR向け質問紙を対象とした2024年の体系的スコーピングレビューでは、数十種類の質問紙が確認されました。主に測られていた構成概念は、プレゼンス、UX、モーションシックネスでした。この結果は、「VR体験」という言葉が複数の異なる要素の集合であることを示しています。AIの分野でも事情は同じです。信頼を測る尺度は多数存在しますが、文脈依存の独自尺度が多く、一般化しにくいことが課題とされています。
代表的な尺度と役割の違い
主要な尺度には、それぞれ得意な測定範囲があります。
- SUS:汎用的なユーザビリティの比較に強い。ただし、VRのプレゼンスや酔いは直接測れない
- UEQ / UEQ+:UXを多面的に測る。UEQ+は研究目的に応じて下位尺度を組み合わせるモジュール方式を採用
- NASA-TLX:精神的要求や努力など6次元で主観的ワークロードを診断する。UXの総合得点として扱うべきではない
- IPQ・ITC-SOPI:仮想環境や各種メディアでのプレゼンスを測る
- VRSQ:VR酔いの症状に特化
- HARUS:ハンドヘルドARの理解しやすさと操作性を測る。一般尺度では拾いにくいAR固有の問題を捉えられる可能性がある
- CUQ:チャットボットのユーザビリティを測る。初期検証の標本が小さいことが限界として明記されている
- TIAS / S-TIAS:AIへの信頼を測る。S-TIASは3項目の短縮版でも、AIの性能差に反応することが報告されている
つまり重要なのは、「良い尺度を一つ選ぶ」ことではありません。何を測りたいかに応じて尺度を組み合わせることが求められます。
カスタマイズUX尺度の基本設計:四層構造という考え方
共通コア+領域モジュール+パルス+客観指標
SUSやUEQの文言を「VR版」「AI版」に置き換えるだけでは不十分です。有効な方法は、製品間で比較できる部分と、その技術でしか生じない部分を明示的に分けることです。具体的には、次の4層で構成する設計が考えられます。
- 共通コア:有効性・努力・制御・満足など、領域を問わず比較できる指標
- 領域モジュール:VRのプレゼンス、ARの位置合わせ、AIの説明品質など、原因の診断に使う指標
- 短時間パルス:1〜3項目程度。体験中の変化を追うための簡易測定
- 客観指標:タスク成功率、エラー、操作ログ、技術性能など
これに加えて、酔い・安全・プライバシー・公平性を「非補償的ガードレール」として独立に扱います。総合点が高くても、これらのリスクは相殺させないという考え方です。
領域別に想定される測定次元
- VR:空間的プレゼンス、操作・エージェンシー、表示の安定性、快適性、タスク有効性
- AR:位置合わせの精度、情報の可読性と遮蔽、現実作業への適合、周囲への状況認識、社会的受容
- 没入型体験:集中・フロー、感覚的一貫性、物語への情動関与、体験後の快適性
- 対話型AI:意図理解、誤りからの回復、限界の理解、ユーザによる制御
- 生成AI:出力の有用性、不確実性の示し方、出力の調整しやすさ(ステアラビリティ)、根拠の追跡しやすさ、ユーザの主体性
- 意思決定支援AI:適切な依存、説明の有用性、異議を申し立てやすいか、公平性
VRと没入型体験を統合しすぎないことにも注意が必要です。没入型体験には、HMDを使わない360度映像や展示なども含まれるためです。
AI評価で特に注意すべき「信頼の校正」
「信頼が高いほど良い」は誤り
AIの能力以上に信頼すれば、過信や誤用につながります。反対に、能力以下にしか信頼しなければ、有用なAIが使われません。したがって、測るべきは信頼の高さそのものではありません。AIの能力に見合った信頼(校正された信頼)と、適切な依存です。
主観得点と行動指標を併用する
意思決定支援AIでは、主観尺度とは別に次のような行動指標を記録することが推奨されます。
- 正しいAI推奨を採用し、誤った推奨を却下できた割合(適切な依存)
- 誤ったAI推奨を採用してしまった割合(過信)
- 正しいAI推奨を却下してしまった割合(過少依存)
主観的な信頼得点が高くても、誤った推奨をそのまま採用しているなら、意思決定支援としては成功とはいえません。
生成AIでも同じ考え方が必要です。ユーザが感じるハルシネーションと、実際の誤りは別物です。そのため、専門家評価や出典検証などの客観指標と突き合わせて解釈する必要があります。
尺度の検証プロセスと日本語化のポイント
段階的に進める心理測定の検証
尺度は、一度アンケートを取っただけでは完成しません。一般的には、次の順序で検証を積み重ねます。
- 構成概念の定義
- 内容妥当性の確認
- 認知インタビュー
- 小規模パイロット
- 探索的因子分析(EFA)
- 独立した標本での確認的因子分析(CFA)
- 信頼性の検証
- 感度(既知群比較・品質操作)の検証
- 測定不変性の検証
必要なサンプルサイズは、因子負荷量や因子数などの条件によって変わります。「項目数の何倍」といった普遍的なルールはないため、シミュレーションで個別に見積もることが望ましいとされます。
信頼性については、αだけでなくωなど複数の指標を報告することが推奨されます。また、プレゼンスや瞬間的な負荷のように状態によって変わる構成概念では、再検査での一致が低くても、必ずしも悪い尺度とは限りません。
翻訳しただけでは「検証済み」にならない
日本語版IPQの作成研究では、順翻訳、逆翻訳、専門家レビュー、認知インタビューといった丁寧な文化適応が行われています。そのうえで著者ら自身が、言語的妥当性と心理測定学的妥当性を区別し、後者は今後の検証課題としています。翻訳の完成を検証の完成とみなさない姿勢は、すべての日本語版尺度に当てはまります。
実装時の注意点:メタデータ・倫理・リアルタイム計測
技術条件はメタデータとして分離する
生成AIは、モデルのバージョンやシステムプロンプト、検索拡張の有無によって体験が変わり得ます。XRでも、デバイスやリフレッシュレートが得点に影響する可能性があります。尺度の文言は技術中立に保ち、技術条件は別のメタデータとして記録すると、バージョン間の比較がしやすくなります。
視線・会話ログは「単なるUXログ」ではない
XRの視線や身体動作、AIとの会話ログやプロンプトには、個人情報や第三者の情報が含まれる可能性があります。日本では、AI事業者ガイドラインや個人情報保護委員会の注意喚起を参照しつつ、次の点を標準の実装要件にすることが望ましいでしょう。
- 収集目的の明確化とデータ最小化
- 仮名化と保存期間の設定
- ログ収集への明示的な同意
体験を壊さない短縮版の運用
体験中にフル質問票を何度も挟むと、測りたい体験そのものを損なう可能性があります。短縮版は、シーンの切り替え時や、意思決定が確定した後など、自然な区切りでのみ提示するのが適切です。ただし、フル尺度から任意に項目を抜き出すのではなく、短縮版も別途検証したうえで採用する必要があります。
まとめ
VR・AR・AIのUXは、単一の尺度や一つの総合値で評価しきれるものではありません。本記事の要点は次のとおりです。
- 既存尺度はそれぞれ得意分野が異なるため、目的に応じて組み合わせる
- 「共通コア+領域モジュール+パルス+客観指標」の四層構造で、比較しやすさと原因の診断を両立する
- 安全・プライバシー・酔い・過信は、総合点に埋もれさせずガードレールとして扱う
- AIでは信頼の高さではなく、能力に見合った信頼と適切な依存を測る
- 翻訳版は、言語的妥当性と心理測定学的妥当性を分けて検証する
今後は、提案尺度の因子構造の確定、日本語と英語の間での測定不変性、生成AIのモデル更新に対する尺度の安定性、そして実務上意味のある最小重要差の確立などが、掘り下げるべき研究テーマになると考えられます。
コメント