生成AIの普及によって、ウェブ上にはAIが書いた文章やAIが手を加えた文章が確実に増えつつあります。こうした文書が検索結果に表示され、さらに次のAIモデルの学習データとして取り込まれていくと、AIが自分自身の出力を学ぶ「フィードバックループ」が生まれる可能性があります。
本記事では、この「AI生成文書の逆流」をどう捉え、どう測定すべきかを整理します。逆流の定義、測定を難しくする要因、長期的な追跡研究の設計、そして「どこまで言えて、どこから先は言えないのか」という証拠の考え方を順に解説します。
AI生成文書の「逆流」とは何か
公開から後続モデルまでの多段階プロセス
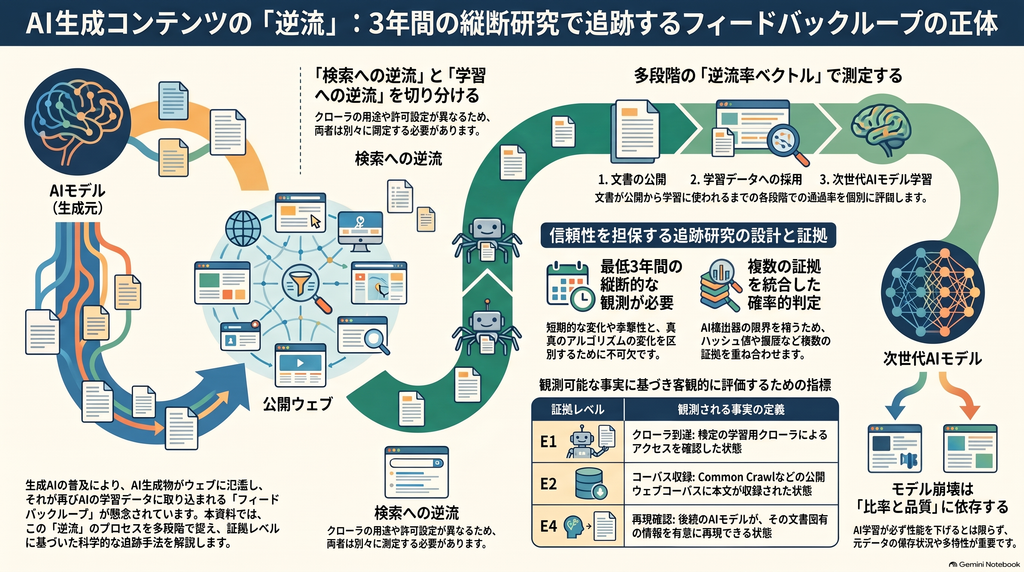
AI生成文書が次のAIモデルに影響を与えるまでには、いくつもの段階があります。大まかには「ウェブで公開される → クローラに発見・取得される → 検索インデックスに登録される → 公開ウェブコーパスに収録される → 学習候補データに入る → 実際に学習に使われる → 後続モデルの出力に影響する」という流れです。
重要なのは、各段階で文書がふるい落とされる可能性があることです。ある段階を通過したからといって、次の段階へ必ず進むとは限りません。そのため「AI生成率」という単一の数字だけでは、逆流の実態を十分に説明できません。段階ごとに通過率を測る「逆流率ベクトル」という考え方が有効になります。
「検索への逆流」と「学習への逆流」は別物
検索と学習は同じウェブを対象にしていても、収集経路が必ずしも同じではありません。たとえばOpenAIは、検索用のクローラと基盤モデルの学習用途に関わるクローラを、robots.txtで個別に許可・拒否できると公開しています。一方で、両方が許可されている場合には、一度のクロール結果を複数の用途に使う可能性があるとも説明しています。
つまり「検索結果に出た」ことと「学習データになった」ことは、別々に測定しなければなりません。この切り分けが、逆流研究の出発点になります。
なぜ今、AI生成コンテンツの逆流を測る必要があるのか
検索と生成AIの統合が二次的なフィードバックを生む
Googleは、生成AIで作られたという理由だけでコンテンツを一律に排除しているわけではなく、ユーザーにとって価値のない大量生成をスパムとして扱う方針を示しています。また、AI OverviewsやAI Modeで参照されるページは、通常の検索インデックスに登録されていることが前提とされています。
これは、AI生成文書が検索結果に混ざるという一次的な影響に加えて、その検索結果がさらにAI回答の根拠として引用されるという二次的な影響が起こり得ることを意味します。検索と生成AIがつながった現在の環境では、逆流の経路がより複雑になっていると考えられます。
「モデル崩壊」は必ず起きるわけではない
AIが生成したデータを繰り返し学習させると、元のデータ分布のまれな部分が失われていく「モデル崩壊(model collapse)」が起こり得ることは、先行研究で示されています。一方で、元の実データを保持したまま合成データを追加していく条件では、崩壊を回避できる場合があることも報告されています。
したがって「AI生成データが混ざれば必ず性能が落ちる」と単純に結論づけることはできません。注目すべきは、AI生成物の存在そのものよりも、その比率、選別の仕方、元データの保存状況、品質、出所の多様性といった条件です。
AI生成文書を正しく識別する難しさ
AI検出器は「真値」ではなく観測装置
逆流を測るには、まずどの文書がAI生成なのかを判定する必要があります。しかし、AI文章検出器は言い換え(パラフレーズ)によって性能が大きく低下し得ることが研究で示されています。さらに、人間が大幅に編集したAI文章や、AIらしい文体で書かれた人間の文章もあり、境界はあいまいです。
特に日本語では、英語向けに調整された判定基準をそのまま使うと誤判定が増える可能性があります。検出器の結果は有用な手がかりですが、それ自体を正解とみなすことは避けるべきです。
複数の証拠を統合した確率的な判定
より堅牢な方法は、複数の証拠を組み合わせて「AI生成である確率」を推定することです。作成時の記録、投稿者によるAI利用の表示、文書の指紋(ハッシュ値)、類似文書の照合、ウェブアーカイブ上の改稿履歴、複数の検出器、文体の変化などを重ね合わせます。
AIか人間かを二択で決めるのではなく確率として扱うことで、判定の不確かさを最終的な推定結果にまで反映させることができます。
逆流を追跡する縦断研究の設計
制御コホートと自然発生コホートの二本立て
研究設計の柱は二つあります。一つは、同じテーマ・同じ参考資料で「AIのみ」「人間のみ」「AI初稿+人間編集」などの作成方法を無作為に割り当てて文書を作る制御コホートです。作成過程が完全にわかるため、判定の基準となる「正解データ」として機能します。
もう一つは、実際のウェブで自然に生まれた文書を継続的に観察する自然発生コホートです。前者で因果関係を推論しやすくし、後者で現実への当てはまりを確保するという役割分担になります。なお、制御コホートの公開は必要最小限にとどめ、各ページが実用的な価値を持つよう配慮することが欠かせません。
検索・クローラ・公開コーパスの同時観測
逆流の各段階を捉えるには、複数の観測点を組み合わせます。固定したクエリ群による検索結果の定期取得、協力サイトのアクセスログによるクローラ到達の記録、Common Crawlなど公開ウェブコーパスへの収録確認、ウェブアーカイブによる文書履歴の追跡などです。
公開コーパスは非常に大規模なため、すべてを複製するのではなく、URLインデックスを起点に必要な部分だけを取り出す方式が現実的です。
3年以上の観測が必要な理由
検索アルゴリズム、クローラの仕様、AIモデル、検出器はいずれも短期間で変化します。単年度の調査では、季節性やウェブ全体の成長と、本当の変化とを区別しにくくなります。最低でも3年程度の縦断観測を行い、途中の政策変更やモデル公開などの出来事の前後を比較することで、傾向をより正確に捉えられる可能性があります。
「学習に使われた」とどこまで言えるのか
外部の研究者にとって最大の壁は、クローズドなAIモデルの実際の学習データが公開されていないことです。そのため、観測できる事実と推測を明確に分ける「証拠レベル」の考え方が重要になります。
- E0:ウェブで公開され、取得可能な状態にある
- E1:特定のクローラによるアクセスを確認した
- E2:公開ウェブコーパスに本文が収録されていることを確認した
- E3:開発者が公開した学習候補データと一致した
- E4:後続モデルで、その文書固有の情報が対照より有意に再現された
- E5:開発者自身が実際の学習使用を確認した
「クローラが来た」という事実だけで「学習された」と断定することはできません。低いレベルから高いレベルへ飛躍しないことが、過大な主張を避ける鍵です。学習への逆流率は一点の数値ではなく、上限と下限の幅として報告するのが適切だと考えられます。
評価指標と分析手法のポイント
「AI文書が検索される率」と「検索結果のAI率」は別
見落とされやすいのが指標の向きです。「AI文書のうち検索に収録された割合」と「検索結果のうちAI文書が占める割合」は、まったく異なる量です。両者を混同すると、結果を大きく誤解させる恐れがあります。指標ごとに分母と分子を明確に定義し、信頼区間を添えて示すことが求められます。
生存時間分析と因果推論
公開から検索登録やコーパス収録までにかかる時間は、生存時間分析で扱うことができます。また「AIが書いたから検索されにくい」のか「品質が低いから検索されにくい」のかを区別するため、品質やドメインの影響をそろえた比較(傾向スコアやマッチングなど)が有効です。同じドメイン内の文書は似た傾向を持つため、統計処理ではその相関も考慮する必要があります。
倫理・法務面で注意すべきこと
日本で研究を行う場合、著作権、個人情報、プラットフォームの利用規約、検索エコシステムへの影響を個別に検討する必要があります。文化庁は「AIと著作権に関する考え方」を公表していますが、研究目的で取得できる可能性と、取得した全文を再配布できることは別問題です。
個人情報についても、公開されている情報だから無条件に保存してよいとは考えず、データの最小化、保存期限、アクセス制限を設けることが望まれます。robots.txtの遵守、個人情報を含まない識別子の利用、削除要請への対応窓口の設置なども、研究の信頼性を支える要素です。
まとめ
AI生成文書の「逆流」は、単一の割合で表せる現象ではありません。公開、クロール、検索登録、公開コーパス、学習候補、実際の学習、後続モデルへの影響という多段階のプロセスとして捉え、段階ごとに測定する必要があります。
また、AI検出器には限界があり、クローズドモデルの学習データは外部から直接見えません。そのため、複数証拠による確率的な判定と、E0〜E5のような証拠レベルを用いて、観測できる範囲と推測の範囲を区別することが重要です。「逆流は起きているか」という二択から一歩進み、その確率、速度、経路、増幅条件を長期的に追うことが、検索エコシステムとAI学習の健全性を考えるうえでの土台になると考えられます。
今後は、日本語に特化したAI検出の精度向上、検索とRAGにおける引用の偏り、実データを保持する学習設計の効果などが、さらに掘り下げるべきテーマとなるでしょう。
コメント