導入:なぜ「それらしさ」の先にある評価が必要なのか
生成AIを使ったマルチエージェント・シミュレーションは、社会実験、市場分析、政策検討などへの応用が期待されています。しかし、エージェントが自然に会話し、もっともらしく振る舞うことと、その結果を現実の意思決定に使えることは別の問題です。
本記事では、まず「それらしさ」だけでは不十分な理由を確認し、検証可能性・妥当性・再現性の定義を整理します。そのうえで、6層の評価フレームワーク、指標とベンチマーク設計、実装・統計の基盤、倫理と運用、実践ワークフローの順に解説します。
生成的エージェントの評価で「人間らしさ」だけでは不十分な理由
believability(もっともらしさ)と妥当性は別物
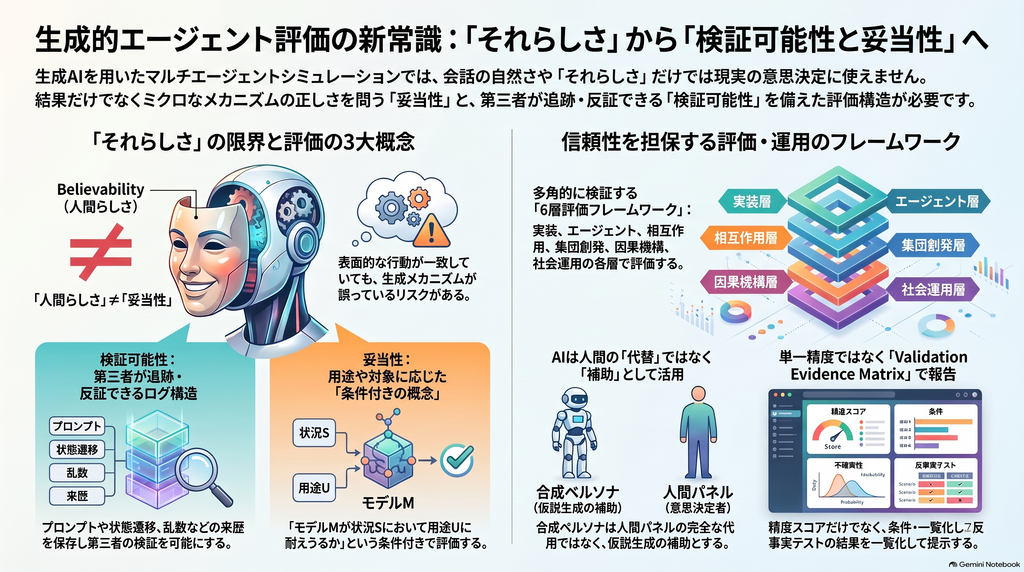
Park et al. の Generative Agents は、記憶・省察・計画を備えたエージェントが仮想社会で一貫した行動や創発的な相互作用を示せることを明らかにしました。ただし、ここで評価された「もっともらしさ」は、現実社会に対する外的妥当性や、因果的なメカニズムの正しさを直接示すものではありません。
人間シミュレーション研究が示す歪みと平坦化
その後の研究では、古典的な心理・経済実験をLLMで再現できる例が報告される一方、系統的な歪みも見つかっています。Aher et al. は一部実験の再現に成功しつつ、過度に「正確すぎる」回答が生じる歪みを指摘しました。また Wang et al. は、人口属性を付与したLLMで人間参加者を置き換えると、集団の見解を誤って表現したり、集団内の多様性を平坦化したりする危険があることを示しています。
つまり、平均的な結果が現実と一致していても、それが誤ったミクロの仕組みから生まれている可能性があります。結果の妥当性(outcome validity)と機構の妥当性(mechanism validity)を分けて検証することが出発点になります。
検証可能性・妥当性・再現性の定義を整理する
検証可能性:第三者が追跡・反証できる証拠構造
検証可能性とは、検証を「実施した」ことではなく、第三者が入力データ、モデル、プロンプト、状態遷移、ツール呼び出し、乱数条件、解析コードなどの来歴をたどり、主張を独立に点検・反証できる性質を指します。W3C PROV の Entity–Activity–Agent モデルは、この来歴を表現する有力な実装手段です。
妥当性は「条件付き」の概念
妥当性は「モデルに妥当性がある/ない」という二値ではありません。「モデルMの、人口P・状況S・期間Hに関する主張Cが、用途Uについてどこまで支持されるか」という条件付きの問いとして扱うべきです。ABMの記述標準である ODD protocol は、この条件を明示する前提として役立ちます。
再現可能性・追試可能性・信頼性・ロバストネス
同一データ・コードから同じ結果を得る「計算的再現可能性」と、独立した実験で一貫した結論を得る「追試可能性」は区別が必要です。生成AIでは外部APIの更新や非決定性があるため、完全な逐語的再現よりも、設定・試行分布・効果の方向・結論のレベルで段階的に再現性を評価するのが現実的です。
また、同じ結果を繰り返し出す「信頼性」は真実性とは異なります。常に同じ偏りを示すシステムは、信頼性が高くても妥当性は低い可能性があります。プロンプトの言い換えやseed、モデル版の変更などに対して結論が崩れないかを問う「ロバストネス」も独立に評価する必要があります。
生成的エージェントを評価する6層フレームワーク
評価を一つの総合スコアにまとめるのではなく、次の6層を別々に確認することが推奨されます。
| 評価層 | 問うべきこと |
|---|---|
| 実装・実行層 | コードと環境は仕様どおり動いたか |
| エージェント層 | 個々の判断は対象主体と整合するか |
| 相互作用層 | 情報伝播・協調・競争の過程は妥当か |
| 集団・創発層 | マクロな分布や時系列は現実・理論と一致するか |
| 機構・因果層 | 介入に対して正しい方向・経路で反応するか |
| 運用・社会層 | 実際の意思決定用途で有効かつ安全か |
この多層構造は、ODD protocol、NIST AI RMF、ISO/IEC 42001・23894といった既存の枠組みとも整合しやすい設計です。
評価指標とベンチマーク設計のポイント
単一の正解率ではなく「評価プロファイル」で報告する
個別行動には一致率や順位相関、回答分布にはJensen–Shannon距離やWasserstein距離、確率予測には較正指標、時系列には転換点の誤差、ネットワークにはクラスタリング係数など、対象ごとに適した指標があります。平均値だけでなく、分散や分布の裾、サブグループ別の誤差も合わせて示すことが重要です。
対照群を複数置き、反事実テストを行う
比較対象としては、人間データ、単純なルールベースモデル、ランダムなどのナイーブな基準、別のLLM、主要構成要素を除いたアブレーションを用意するのが望ましいとされます。さらに、次のような検査を組み合わせると、表面的なパターン模倣と因果的な応答を区別しやすくなります。
- negative control:理論上影響しない介入で結果が変わらないか
- metamorphic test:意味を保った言い換えで結論が崩れないか
- identity swap:無関係な属性だけを変えて結果が不当に変わらないか
固定問題集から「検証装置」としてのベンチマークへ
公開ベンチマークや古典実験はLLMの学習データに含まれている可能性があります。そのため、非公開のholdout、手続き生成されるシナリオ、分布外シナリオなどを分けて用意し、記憶による「再現」と一般化を区別することが求められます。AndroidWorldのように、環境の状態そのもので成功を判定する設計も参考になります。
再現性を支える実装と統計手法
来歴ログとAgent Card で証拠を残す
最終出力だけでなく、実験を生み出した証拠のつながりを保存することが検証可能性の核心です。実験ID、モデルのバージョン、推論設定、プロンプトのハッシュ、状態変化、ツール呼び出し、コードのコミットなどを、書き換えられない形で記録します。Model Cards や Datasheets に加え、persona生成方法や停止条件などを記録する Agent Card / Simulation Card の整備も有効と考えられます。
「有意差なし=妥当」としない
人間データとの比較で有意差がなかったとしても、それは検出力不足による可能性があります。「十分に近い」ことを示したい場合は、事前に許容幅を定めた等価性検定や非劣性設計を使うのがより直接的です。
階層モデル・クラスタブートストラップ・感度分析
シミュレーション内のエージェントや会話は互いに依存しているため、メッセージ1件ずつを独立サンプルとして扱うと擬似反復になります。シナリオやrunの変動を分ける階層モデル、独立単位ごとに再標本化するクラスタブートストラップが基本です。また、エージェント同士が影響し合う環境では、直接効果と波及効果を区別する因果推論の設計が欠かせません。結論が特定のプロンプトやseedでしか成立しないなら、それは「脆弱な結果」として報告すべきです。
倫理・ガバナンスと運用時の妥当性
人間の「代替」ではなく「補助」として位置づける
合成ペルソナを「無料の人間パネル」とみなす設計は、現時点で妥当性が立証された方法とはいえません。生成的エージェントは、仮説生成やシナリオ探索、人間調査の事前検討を補助する道具として扱うのが安全です。実在人物のデータを扱う場合は、取得・目的・保持・削除・同意といったデータライフサイクル全体の設計と、法域ごとの確認が必要になります。
Human-in-the-loop と継続的な監視
人間を配置するだけでなく、何を確認し、どの条件で介入できるかまで設計することが重要です。運用では、入力・挙動・性能・安全性・サブグループ・モデル版の各ドリフトを分けて監視し、外部APIのモデル更新を検知したら再検証を行う仕組みが求められます。
実践ワークフローと Validation Evidence Matrix
実務では、検証を開発の最終工程ではなく、計画から運用終了まで続く「エビデンスのライフサイクル」として設計します。主な流れは次のとおりです。
- 目的・対象・許容誤差を含めた「主張」を具体的に固定する
- 期待される機構や介入方向を理論として先に置く
- 評価項目・許容幅・除外条件を事前登録する
- データ・プロンプト・モデル・コードをバージョン管理する
- 決定論的部分から因果・敵対的シナリオまで段階的に検証する
- 不確実性と感度を報告し、独立レビューを経てリリースする
- 運用後も条件変化に応じて再検証する
最終報告は「精度○%」ではなく、主張ごとに対象条件・証拠・不確実性・反事実・ロバストネス・限界・判定を並べた Validation Evidence Matrix を中心にすると、どの範囲の意思決定なら正当化できるかを第三者が確認しやすくなります。
まとめ:生成的エージェントの信頼性は「証拠の連鎖」で決まる
生成的エージェントの信頼性を高めるうえで重要なのは、出力をより自然にすることではなく、主張→実験→実行履歴→統計的証拠→反事実→運用判断を途切れなく結ぶことです。
- 「人間らしさ」は妥当性の一側面にすぎず、結果と機構を分けて検証する
- 妥当性は用途・対象・期間に依存する条件付きの概念として扱う
- 6層の評価、複数の対照群、反事実テストで多面的に確かめる
- 来歴ログ、等価性検定、階層モデル、感度分析で再現性と不確実性を示す
- 合成ペルソナは人間の代替ではなく補助として使い、運用後も監視を続ける
今後は、機構のもっともらしさを段階的に評価する手法や、Agent Card の標準化、相互作用がある環境での因果推論など、評価方法論そのものの研究がさらに求められていくと考えられます。
コメント