導入:身体性コーディングはなぜ「重い」のか
身体の姿勢、関節の位置、ジェスチャ、視線、接触、対人相互作用。これらを映像に同期させて人が記述・分類する作業を、本記事では「身体性コーディング」と呼びます。行動観察、リハビリ評価、スポーツ解析、会話研究など、使われる分野は広がっています。
ただし作業は大変です。コード体系の訓練が要り、同じ場面を何度も見返し、開始と終了の時点を決め、評価者間の一致まで確かめなければなりません。この負担を軽くする手段として注目されているのが、映像注釈ツールとAIによる半自動アノテーションです。
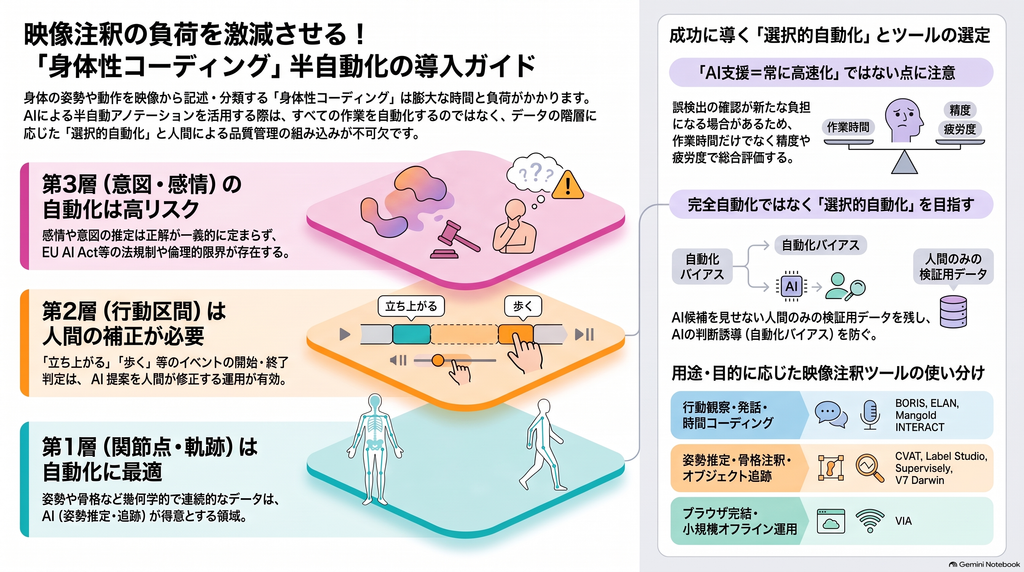
本記事では次の4点を順に整理します。
- 身体性コーディングの3つの層
- ツールの選び方
- 半自動化の効果の正しい測り方
- 倫理的・法的な限界と、実務で使えるワークフロー
身体性コーディングとは:自動化しやすさで3層に分ける
半自動化を考えるときは、まず「何をラベルするのか」を3つの層に分けると見通しが良くなります。
第1層:姿勢・関節点・軌跡など観察可能な情報
関節点の位置、身体領域、移動軌跡、接触の開始と終了などです。幾何学的で時間的に連続しているため、機械支援に最も向いています。
第2層:行為・イベントの時間区間
「立ち上がる」「歩く」「触れる」といった区間のカテゴリー化です。姿勢データは手がかりになりますが、行為の境界をどう定義するか、文脈をどう読むかという判断が残ります。
第3層:意図・感情・社会的意味
「援助」「躊躇」「痛み行動」「集中」などの解釈です。ここでは正解が一つに定まらないことも多く、評価者同士の不一致が、概念そのものの曖昧さを示している場合もあります。
一般に、層が上がるほど人間の判断と明確な操作的定義が欠かせなくなります。半自動化の主な対象は第1層、補助的に第2層と考えるのが現実的です。
映像注釈ツールの選び方:用途別の比較ポイント
ツール選びで差が出るのは、「動画に印を付けられるか」ではありません。データをどこに置くか、AI提案をどう組み込むか、修正履歴をどう残すか、複数の評価者をどう管理するかです。
行動観察・会話研究向けのツール
- BORIS:イベントや状態の時間コーディングに強く、評価者間信頼性の確認にも向きます。
- ELAN:発話とジェスチャを複数の階層(tier)で重ねて記述できます。
- Mangold INTERACT:時刻精度の高い行動コーディングに特化した商用ツールです。
いずれも、AIを導入する前の手動ベースラインづくりに適しています。
姿勢推定・追跡向けのツール
- CVAT、Label Studio:骨格(skeleton)注釈、物体追跡、外部モデルとの接続に対応し、自前環境での運用も可能です。
- Supervisely、V7 Darwin、Encord:AIによる追跡やセグメンテーション支援を備えた商用プラットフォームで、大規模なチーム運用に向きます。
- VIA:ブラウザだけで動く軽量ツールで、オフライン運用を重視する小規模研究に有力です。
「万能ツール」を探さない
例えばリハビリ動画でも、「膝の関節点を取る」「立ち上がりの開始と終了を決める」「介助が必要だったかを判定する」は別々の仕事です。目的に応じてツールと工程を分けて設計するほうが、結果的に負荷は下がりやすくなります。
半自動アノテーション技術:機械にどの操作を任せるか
半自動化は「AIアノテーション」とひとまとめにするより、どの人間操作を置き換えるかで分類すると実務に落とし込みやすくなります。
姿勢推定と多人数追跡
DeepLabCut、SLEAP、BlazePoseなどは、毎フレーム関節点を置く作業を肩代わりします。少数の手動ラベルから学習できる手法も報告されています。一方で、撮影角度が変わる場面、遮蔽、人物同士の交差、学習データと異なる対象集団には弱い可能性があります。
動画セグメンテーションと補間
SAM 2のような手法は、一度指定した対象を動画全体で追跡し、途中で人が修正できます。キーフレーム補間は計算負荷が小さく、滑らかな動きには効果的です。ただし急な動作やカット編集には向きません。
アクティブラーニングと修正型UI
モデルの確信度が低い箇所や、遮蔽が多い場面を優先して人に見せる設計です。すべてを見る作業から「必要な箇所だけ直す」作業へ移すことが狙いです。ただし、確信度がモデルの不確実性を正しく反映していることが前提になります。
負荷軽減の効果:「AI支援=高速」とは限らない
研究報告を見ると、動画セグメンテーションや3D注釈では、半自動化で大幅な時間短縮が得られた例があります。しかしその効果はタスク、データ、UIに強く依存するため、身体性コーディング全般にそのまま当てはめることはできません。
注意すべきなのは、支援によって精度や主観的な負荷は改善したのに、作業速度はかえって落ちた例も報告されていることです。誤った候補、特に誤検出が作業を中断させ、それを一つずつ確かめる持続的な注意が新たな負担になり得ます。また、長時間作業での疲労軽減を直接確かめた研究は、まだ十分ではないとみられます。
導入時に測るべき指標
時間だけで評価せず、次の指標を手動条件と支援条件で比較することをおすすめします。
- 動画1分あたりの作業時間
- 専門家判定に基づくラベル品質
- 評価者間信頼性(κ係数、α係数、ICCなど)
- AI提案の採用率・修正率・削除率
- NASA-TLXによる主観的負荷
- セッション前後の疲労
- 年齢・身体特徴・撮影条件別の誤差
判断の基準は「AIの精度」ではなく、「人とAIを合わせたシステム全体が手動のみより良いか」です。
倫理的限界と法規制:身体映像は「単なる学習データ」ではない
自動化バイアスと公平性
AIの候補が人の注意を誘導し、微妙なよろめきのような変化が見落とされる可能性があります。また、既存の姿勢推定データセットには人口統計属性が乏しく、肌色、年齢、体型、補助具の有無などによる性能差を評価すること自体が難しいと指摘されています。平均精度が高いことだけを根拠に、医療や高齢者支援の現場へ適用することは避けるべきです。
プライバシーと同意
顔、歩き方、病室や住居の背景、映り込んだ第三者などから、想定外の情報が推測されることがあります。顔をぼかすだけで完全に匿名化できるとは限りません。撮影への同意が、AI解析やモデル再学習への同意まで含むとも限りません。
日本・EUの規制動向
日本では、個人情報保護法と個人情報保護委員会によるカメラ利用の考え方、医学系研究の倫理指針、AI事業者ガイドラインの確認が欠かせません。倫理指針は改正の動きがあるため、現行版と今後適用される版を取り違えないよう注意が必要です。
EUでは、GDPRに加えてAI Actが重要です。AI Actでは、職場や教育機関での感情認識などが原則禁止の対象とされています。「腕の屈曲角を検出する」システムと「怒っている・集中していないと推定する」システムは、リスクの水準がまったく異なります。
実践ワークフロー:手動ベースラインを壊さない半自動化
推奨されるのは、次の流れです。
- 研究目的と構成概念を定義する
- 同意取得と倫理審査を済ませる
- コードブックとゴールドセットを作る
- 人間のみで二重コーディングを行い、信頼性を確認する
- 半自動モデルで候補を生成する
- 低確信度の箇所や難しい場面を優先して人が修正する
- 独立した担当者が品質管理と最終判定(adjudication)を行う
- モデルのバージョンと修正履歴を監査ログに保存する
実務チェックポイント
- AI候補を見せない「手動ホールドアウト」を残し、AIに誘導された共通誤差を検出する
- 機微な映像は自前環境(オンプレミス)での運用を優先して検討する
- 元動画、関節点データ、ラベル、モデル重みを別々のデータ区分として管理する
- 作業者の生産性だけでなく、休憩、疲労、誤提案への心理的負担も把握する
まとめ:目指すのは「完全自動化」ではなく「選択的自動化」
- 身体性コーディングの負荷軽減は、姿勢、領域、追跡、候補区間といった機械が得意な部分に絞って自動化するのが有望です。
- ツールは目的別に選びます。行動の時間コーディングにはBORISやELAN、姿勢や追跡にはCVATやLabel Studioが候補になります。
- 半自動化は速度を下げることもあるため、品質、負荷、疲労、公平性を同時に測る必要があります。
- 感情や意図の推定は倫理的・法的リスクが一段高く、単純な姿勢検出とは区別して扱うべきです。
今後掘り下げるべきテーマは、半自動化が長時間作業の疲労に与える影響、AI提案が人の判断を誘導する自動化バイアスの定量化、そして臨床集団や障害のある人に対する姿勢推定の公平性です。問われているのは「何%を自動化できたか」ではありません。「どの判断を人に残せば、研究の妥当性と人の権利を両立できるか」です。
コメント