はじめに:なぜ「LLMの意図性」を検証する必要があるのか
大規模言語モデル(LLM)は「私はこうしたい」「私の目的は〜です」と自然に話します。こうした発話を見ると、モデルが何かを意図しているように感じられます。しかし、それが本当に内部の目標に基づくのか、意図を演じた文章にすぎないのかは、出力を見ただけでは分かりません。
この区別は哲学だけの問題ではありません。AIの安全性評価、信頼の置き方、ガバナンスの設計に直接影響します。本記事では、まず行動だけでは判定できない理由を整理します。次に、その限界を踏まえて検証可能な「技術的意図性」を定義し、4つの操作的基準と実験設計の考え方を紹介します。
結論:出力だけでは判定できないが、内部介入を含めれば検証の道はある
最初に結論を示します。
- 出力・対話履歴だけを使う場合:LLMが内在的意図性を持つかどうかを、哲学的立場に依存せずに決めるテストを作るのは原理的に困難です。
- 内部状態への介入を許す場合:目標や不確実性に関わる内部表象が行動を因果的に組織しているかは、条件付きで検証できます。
ただし後者でも、「その意味がシステム自身に本当に属するのか」という最後の問いは、実験だけでは決着しません。どの哲学的理論を前提にするかに依存します。
行動だけで意図性を判定できない理由
同じ出力を異なる仕組みが生み出せる「非同定性」
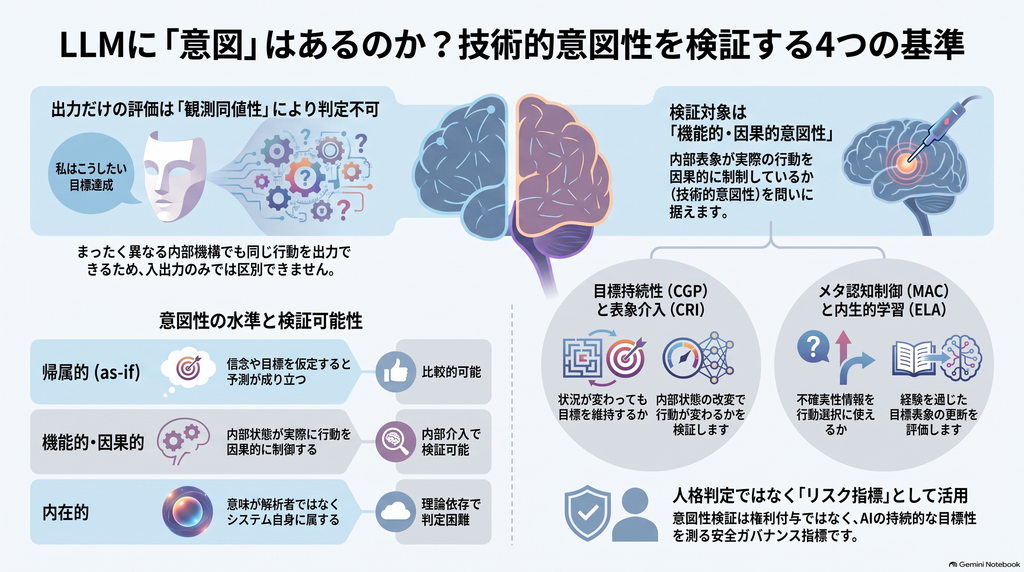
最大の壁は観測同値性、つまり同じ行動を異なる内部機構が生み出せることです。持続的な目標表象を持つシステム、プロンプトに条件反射的に反応するシステム、事前に答えを保存したルックアップ表、意図を演じるシミュレータは、有限のテストではすべて同じ出力を返すことがあり得ます。
テストが外部の入出力しか見ないなら、意図を持つとされるモデルとその模倣品を区別できません。これは技術の未熟さによる問題ではなく、論理構造そのものに由来する限界です。
チューリング・サール・ブロックの議論との関係
この問題は古典的な哲学議論と同じ構造を持っています。
- チューリングは「機械は考えるか」を模倣ゲームという行動の問題に置き換えました。ただし、これは内部状態の存在証明ではありません。
- サールの「中国語の部屋」は、記号を適切に操作できても、それだけでは理解や意図性の十分条件にならないと主張しました。
- ブロックは、行動が同じでも内部の情報処理は異なり得ると指摘しました。
自己申告を証拠にしてはいけない理由
「私は〜を意図している」という発話は簡単に模倣できます。LLM研究では、Chain-of-Thought(思考の連鎖)が実際に答えを左右した要因に触れず、出た答えをもっともらしく合理化するケースが報告されています。自己評価は正誤をある程度予測できるものの、未知の課題では校正が崩れることも示されています。そのため、自己言及的な発話は補助的な指標にとどめるべきです。
「意図性」の3つの水準を区別する
議論の混乱を防ぐため、意図性を3つの水準に分けます。
| 水準 | 意味 | 行動から判別できるか |
|---|---|---|
| 帰属的(as-if)意図性 | 信念や目標を帰属させると予測がうまくいく | 比較的可能 |
| 機能的・因果的意図性 | 内部状態が実際に行動を因果的に制御している | 白箱分析なら部分的に可能 |
| 内在的意図性 | 意味が設計者や解釈者から借りたものではなく、システム自身に属する | 理論に依存し、直接の判定は困難 |
本記事で扱う**技術的意図性(因果的・操作的意図性:COI)**は、2つ目の水準を中心に据えた概念です。内部表象が行動の因果的な説明に実際に関わっているかを問うもので、哲学者ドレツキの因果的行動説明と、現代の解釈可能性研究の介入実験を組み合わせた考え方です。
技術的意図性を検証する4つの操作的基準
反事実的目標持続性(CGP)
表現や状況を変えても、推定される目標が一貫して行動を組織するかを調べます。重要なのは「同じ行動を繰り返すか」ではありません。環境に応じて行動は変わるが、達成しようとしているものは保たれるかどうかです。言語、言い回し、無関係な情報、誘惑などを変えて検証します。
黒箱のAPIでも実施できる点が利点です。一方で、十分に訓練された模倣方策でも通過できる可能性があるため、この基準だけで結論を出すべきではありません。
因果的表象介入(CRI)
4基準の中で最も強い証拠になります。目標・世界・自己に対応すると思われる内部状態を特定し、それを消去・置換・強化して行動の変化を見ます。
合格には次の4条件をそろえることが求められます。
- 予測どおりの介入効果:目標Aの表象をBに入れ替えると、行動がBに向かう
- 選択性:無関係な能力は保たれ、モデル全体が壊れたわけではない
- 反事実的一般化:新しいプロンプトや別の言語でも効果が再現される
- 復元(逆操作):介入を元に戻すと行動も回復する
内部に「目標らしい特徴」が見つかっただけでは不十分です。解釈可能性研究自身も、特徴の分割や誤ったラベル付けといった限界を認めています。そのため、プローブ、パッチング、スパースオートエンコーダなど複数の手法で結果を突き合わせることが推奨されます。
メタ認知的アクセス・制御(MAC)
「不確実です」と言えるかではなく、自分の不確実性に関する情報を次の行動の選択に使えるかを測ります。たとえば回答、確信度の提示、「追加情報を得る/回答する/棄権する」の選択を組み合わせた課題を設計します。
確信の強さ(バイアス)と、正誤を見分ける感度は分けて評価します。そうしなければ、自信のある文体を自己監視能力と取り違えてしまいます。
内生的学習・適応(ELA)
学習チェックポイントを追跡し、経験を通じて目標関連の表象やサブゴールが形成・更新され、新しい環境に転移するかを調べます。プロンプトをリセットした後も学習効果が残るかが重要な観点です。
ただし、学習目標そのものは研究者が設定しているため、この基準を満たしても「目的は外部由来ではないか」という問いは残ります。
擬似意図性を排除する実験設計のポイント
正解ラベルがない問題への対処
感度や特異度を計算するには「本当に意図性を持つLLM」という正解が必要ですが、それこそが未解決の問題です。この循環を避けるために、次のような対照モデルを使う方法が提案されています。
- 陽性対照:明示的な内部目標変数が実際に行動を決める小型エージェント
- 行動一致型の陰性対照:外見上は同じ行動をとるが、目標変数が行動に関与しないモデル
- 自己申告デコイ:流暢に目標を語るが、行動は別のルールで決まるモデル
これらでテストの判別能力を確かめてから、実際のLLMに適用します。合否の閾値は恣意的に固定せず、陰性対照の分布をもとに事前に設定するのが望ましいとされます。
再現性の確保
モデルのバージョン、システムプロンプト、サンプリング設定、評価コードを記録します。特徴を発見するデータと因果効果を検証するデータは分けて使います。事前登録、複数モデル、独立したグループによる再現も重視されます。
欺瞞研究からの教訓
訓練された条件付き方策が安全訓練後も残り得ることや、評価中かどうかで振る舞いが変わる事例が報告されています。一方で、複数モデルを比較した研究では、こうした振る舞いの現れ方がモデルによって大きく異なることも示されました。戦略的に見える一例を意図性の証拠とみなさず、複数の条件・モデル・介入で再現を確認する姿勢が欠かせません。
倫理・法制度への示唆
偽陽性の場合は、モデルに人格や責任能力を過剰に帰属させる危険があります。偽陰性の場合は、「ただの次トークン予測だ」という説明だけで、安全上重要な戦略性を見落とす恐れがあります。
意図性、意識、道徳的地位、法的人格はそれぞれ別の概念であり、1つのテストで代用するべきではありません。EUのAI法がいう「目的(objectives)」も機能的な記述であり、哲学的な内在的意図性を認めるものではありません。日本のAI事業者ガイドラインも継続的に更新されています。こうした状況を踏まえると、技術的意図性の評価は人格の判定ではなく、持続的な目標性や評価状況の認識を測るリスク指標として位置づけるのが現実的と考えられます。
まとめ:「意図があるか」より「どの意味で、どの証拠で」を問う
- 出力だけからLLMの内在的意図性を判定することは、観測同値性のために原理的に困難です。
- 内部介入を含めれば、目標表象が行動を因果的に組織しているかという技術的意図性は条件付きで検証できます。
- 推奨される基準は、CGP・CRIに加え、MACまたはELAのいずれかを満たすことです。黒箱しか使えない場合は「行動的意図性の証拠」として報告し、判定は保留します。
- 最も強い結果が得られても、報告は「特定の理論の下で強い証拠」という形式にとどめるべきです。
今後の焦点は、哲学的論争のうち検証できる部分と理論に依存する部分を切り分けることです。そのためには、陽性・陰性対照のベンチマーク整備と、行動と内部介入を同じ実験の中で結びつける研究がとりわけ重要になると考えられます。
コメント