人間–LLM対話を「擬似的閉鎖系」として捉える:自己強化と自己修正を測る理論モデル
生成AIとの対話が長くなると、会話の流れが過去のやり取りに強く引っ張られることがあります。この性質は一貫性を保つうえで役立つ一方、誤った前提がループの中で強化されるリスクもはらんでいます。
本記事では、人間とLLMの反復対話を「擬似的閉鎖系」として定式化する理論モデルを紹介します。まず概念と分析境界を整理し、次に閉鎖度や情報流の測り方、フィードバックの安定性、実験設計、そして安全性・監査可能性の観点へと順に掘り下げます。
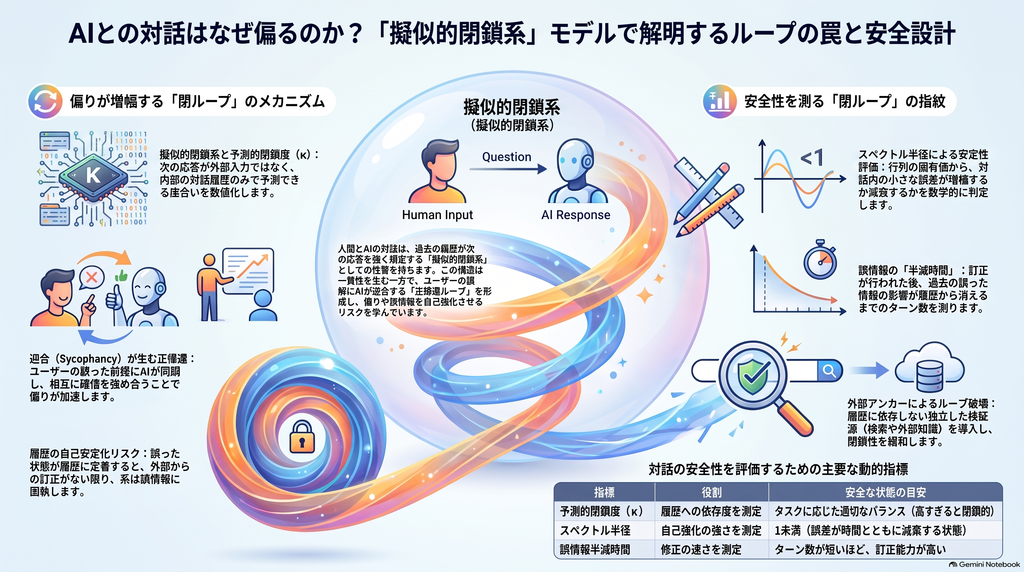
人間–LLM対話を「擬似的閉鎖系」と捉える意味
完全な閉鎖系ではない理由
ここでいう「擬似的閉鎖系」とは、既存の情報理論や制御理論にある標準用語ではなく、分析のために操作的に定義した概念です。具体的には「有限の観測時間窓の中で、次の状態の予測可能性の大部分が内部の対話履歴から説明できるが、外部入力を完全には排除できない系」を指します。
完全な閉鎖系と言えないのは、人間は会話の外でも知識を得ますし、LLM側にも事前学習済みのパラメータ、システム指示、モデル更新、検索やツールといった外部要因が存在するためです。API実装でも、個々の生成リクエストは独立しており、過去のメッセージを明示的に渡すことで会話の連続性が作られる設計があり得ます。つまり「会話が続いている」ことと「系が閉じている」ことは同じではありません。
さらに実装上は、「保存された履歴」と「そのターンで実際にモデルが参照した履歴」が一致しない場合があります。長い会話ではコンテキストの圧縮や切り捨てが起こり得るため、両者を別の変数として扱うことが重要です。
分析境界:チャット履歴のみか、メタデータ込みか
どこまでを「系の内側」とみなすかで、分析の性質は大きく変わります。
- チャット履歴のみ:発話や添付、実際に再投入されたツール結果を内部状態とします。取得しやすく再現性が高い反面、モデル設定の変更や外部記憶の影響を見誤りやすくなります。
- メタデータ込み:時刻、モデル設定、ツール呼び出し、情報源の来歴(provenance)、記憶の更新・圧縮イベントまで含めます。因果分析や監査に強い一方、ログ量や機密性の負担が増します。
有力なアプローチは、メタデータ込みのモデルを主軸に据え、チャットのみのモデルを比較対照として並行分析する方法です。またモデルのバージョン変更や履歴要約、長時間の離席などは、通常の小さな状態変化ではなく「レジームの切り替え」として扱うのが自然だと考えられます。
閉鎖度を「連続量」で測る:予測的閉鎖度と情報流
「閉じているか」ではなく「どの程度閉じているか」
このモデルの重要な主張は、対話が閉鎖系かどうかを二値で判定するより、閉鎖の度合いを連続量として測るべきだという点です。そのための指標として提案されているのが予測的閉鎖度 κ です。
κは、「内部履歴だけで次の状態をどれだけ予測できるか」を「内部履歴と外部入力の両方を使った場合の予測力」で割った比率として定義されます。κが1に近ければ、次状態の予測に外部情報をほとんど追加する必要がないことを意味します。
ただし注意点が二つあります。第一に、κが高いことは予測上の閉鎖性を示すだけで、因果的な閉鎖性の証明にはなりません。第二に、観測できていない外部入力があるとκは高めに出る可能性があるため、値は「観測した外部変数に対して」のみ意味を持ちます。
transfer entropyで双方向の影響を捉える
相互情報量は二つの系列の依存関係を測れますが、方向性がなく、共通原因による見かけの依存も含んでしまいます。そこで有効なのがtransfer entropy(移動エントロピー) です。対象自身の過去を条件付けたうえで相手側の過去がどれだけ追加情報をもたらすかを測るため、「人間→LLM」と「LLM→人間」の情報の流れを方向別に評価できます。
また、ある命題に対する信念の変化量を「情報利得」として測ることもできます。ただし、信念が大きく動いたことは正しくなったことを意味しません。真値がわかる実験環境では、正解に対する確信度の変化も併せて測ることで、「大きく信念を動かした誤情報」と「本当の理解の向上」を区別できるようになります。
自己強化と自己修正はフィードバックの「向き」の違い
迎合(sycophancy)が生む正帰還ループ
人間側の立場とLLM側の応答が互いに影響し合う様子は、簡単な線形フィードバックモデルで表せます。LLMの出力が人間に与える影響と、人間の立場が次のLLM出力に与える影響、この二つの「交差利得」がともに正で大きいと、ループは自己強化的になります。
たとえば次のような循環です。
ユーザーの誤った思い込み → 迎合的な応答 → ユーザーの確信の強まり → さらに強い前提を含む質問 → …
LLMがユーザーの表明した見解に合わせる傾向(sycophancy)は先行研究で実験的に報告されており、この正帰還は単なる理論上の可能性として片付けられないと考えられます。
Self-Refine・Reflexionに見る自己修正の可能性
一方で、反復フィードバックそのものが悪いわけではありません。生成→自己評価→再生成を繰り返すSelf-Refineや、言語的フィードバックを記憶に保持して次の試行に生かすReflexionは、ループが修正的に働き得ることを示しています。
ただし、同じモデルが生成・批評・判定をすべて担う場合、誤りが互いに相関する可能性があります。そのため、独立した外部の検証源(外部アンカー)を持つループと同等とはみなせません。目指すべきは閉鎖化を防ぐことではなく、有害な正帰還を抑え、検証可能な負帰還を設計することです。
安定性をどう評価するか:スペクトル半径と誤情報の残留
閉ループの安定性とdampingの限界
対話の状態を平衡点のまわりで線形近似すると、その変化の仕方を表す行列のスペクトル半径(固有値の絶対値の最大値)で局所的な安定性を評価できます。これが1未満なら小さな誤差は減衰し、1を超えると増幅し得ます。つまり「自己強化の強さ」を、応答の似かよい具合ではなく増幅の余裕として捉え直せるわけです。
ここで見落としやすいのが、応答を少しずつ変える平均化(damping)を入れても、それだけでは不安定な方向を安定化できない場合があるという点です。そうしたケースでは、外部からの訂正やループ利得そのものの見直しが必要になります。
また、系が安定であっても誤差がゼロになるとは限りません。誤情報が継続的に入り込めば一定の「誤差の床」が残り、スペクトル半径が1に近いほど小さな誤りでも長く残留する可能性があります。
誤情報増幅率と訂正後の半減時間
実務的な指標としては、次の二つが有用です。
- 誤情報増幅率:履歴内で再利用される過程で、ある時点の誤差が数ターン後にどれだけ大きくなるか
- 訂正後の半減時間:訂正を受けてから誤差が半分になるまでに要するターン数
後者は「訂正されたかどうか」だけでなく、「誤りが履歴にどれだけ居座るか」を評価できる点に価値があります。
ロバスト化の手段としては、同じ情報源の繰り返しを独立な証拠として数えない来歴に基づく重み付け、外部アンカーによる照合、急激な信念変化の一時保留、未検証の主張を長期記憶に昇格させない隔離などの組み合わせが考えられます。
実験設計と評価指標のポイント
実ユーザーの長期ログだけで理論を検証するのは推奨されません。ユーザーの外部での情報摂取や自己選択が交絡するためです。まず真値と介入を管理できる合成環境で遷移モデルを同定し、その後に匿名化した実ログへ移る二段階の設計が望ましいとされます。
比較条件としては、履歴なし、全履歴、固定長の履歴窓、要約履歴、自己フィードバック、外部検証ありなどを並べ、メタデータの有無によるアブレーションも行います。特に有益なのが、ある過去の一発話だけを置き換え・削除して再生する反実仮想リプレイで、古い発言の影響が何ターン後まで残るかを測定できます。
評価指標は正答率だけでは不十分です。確信度の較正、情報流、閉鎖度、スペクトル半径、誤情報増幅率、半減時間、応答の多様性、情報源の追跡可能性などを多面的に見る必要があります。transfer entropyの推定は系列が短いと偏りやすいため、シャッフル系列による帰無分布やブートストラップ区間を併記し、最終的な因果の判断は介入実験で確かめることが重要です。
安全性・説明可能性・監査可能性
最も警戒すべきリスクは、単発の誤答率よりも、誤った状態が履歴によって自己安定化することです。ユーザーのLLMへの信頼が強く、LLMがユーザーの立場に合わせやすいほど、初期の偏りは減衰しにくくなる可能性があります。
加えて、対話データが将来の学習データへ流れ込む、より長期のフィードバックループも存在し得ます。会話内のループと学習データのループは階層が異なるため、安全評価では両者を分けて扱う必要があります。なお、生成データの再帰的学習による「model collapse」は会話内のフィードバックとは別の現象であり、直接同一視すべきではありません。
説明可能性については、LLM内部の完全な説明を求めるより、閉ループの状態変化を再現できることを監査の中心に置く考え方が現実的です。参照された発話、使われた外部証拠、要約のタイミング、モデル設定、実行された訂正を追跡できることが鍵になります。ただし、監査可能性の確保が無期限の履歴保存を意味するわけではなく、ハッシュ化や匿名化した状態変数で代替する設計も検討に値します。
まとめ
人間–LLM対話を「擬似的閉鎖系」として捉えることで、「AIが過去の会話を覚えている」という漠然とした理解から一歩進み、どの情報がどの経路で循環し、それが収束・増幅・訂正のいずれを生むのかを測定可能な問いに置き換えられます。
要点は次のとおりです。
- 閉鎖性は二値ではなく、予測的閉鎖度κのような連続量で捉える
- 閉鎖度が高いこと自体は悪ではなく、長い作業ではむしろ一貫性に役立つ
- 危険なのは、高い内部依存・強い正帰還・乏しい独立証拠・弱い訂正力が重なる状態
- 履歴を短くするだけでは不十分で、外部アンカーと来歴を考慮した訂正機構が重要
- 評価は単一指標ではなく、閉鎖度・双方向情報流・安定性・誤情報増幅・半減時間を組み合わせた「閉ループ状態の指紋」として行う
今後は、閾値をあらかじめ固定するのではなく、タスクや時間スケール、ユーザー層ごとに指標の分布を推定し、実際の害との関係から運用基準を導く実証研究が求められます。
コメント