人の対話は言葉だけで成り立っているわけではありません。うなずき、視線、手振り、表情といった非言語コミュニケーションが、意味の補足や感情の共有、話者交代のタイミングまでを支えています。生成AIが自然な対話相手になるためには、この「言葉以外のチャネル」をどう理解し、どう表現するかが大きな鍵になります。
本記事では、まず非言語行動を説明する認知科学の理論モデルを整理し、次に生成AIによるジェスチャー生成やマルチモーダル対話モデルの動向、認識・生成の技術、データセットと評価手法を紹介します。最後に教育・医療・接客への応用と、今後掘り下げるべき研究テーマを示します。
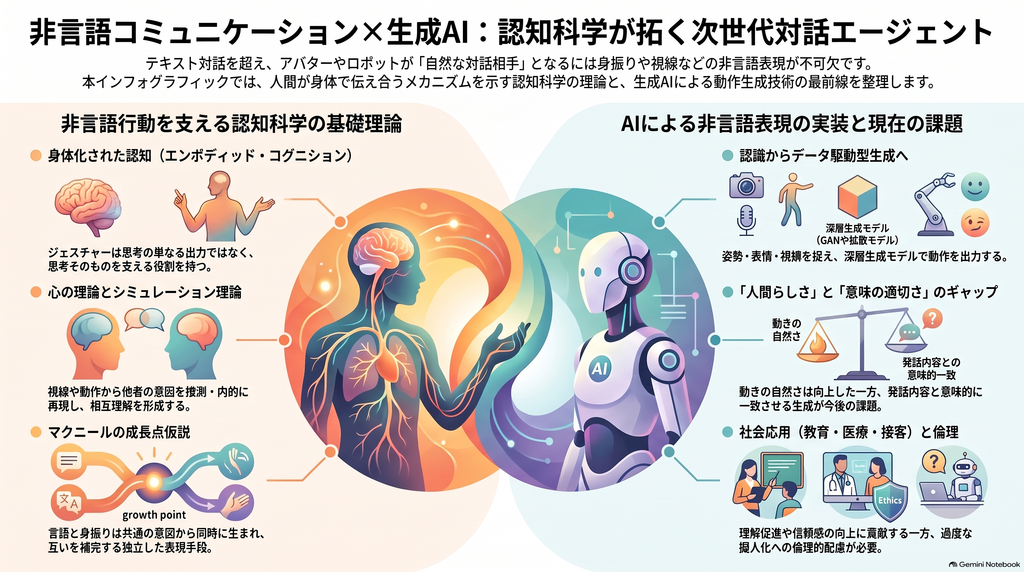
非言語コミュニケーションがAI対話で重要になる理由
テキストチャットのAIは急速に高性能化しましたが、アバターやロボットのように「身体」を持つ対話エージェントでは、言葉の正しさだけでは不十分です。発話と噛み合わない身振りや、相手を見ない視線は違和感を生み、信頼感を損なう可能性があります。逆に、適切なタイミングのうなずきや意味に合ったジェスチャーは、理解を助け、安心感を高めると考えられています。つまり非言語コミュニケーションは、対話AIを「情報を返す道具」から「一緒に話せる相手」へ近づけるための中核要素なのです。
非言語コミュニケーションを支える認知科学の理論モデル
AIに非言語行動を実装する前提として、人間がなぜ・どのように身体で伝え合うのかを説明する理論を押さえておく必要があります。
身体化された認知(エンボディッド・コグニション)
身体化された認知とは、思考や理解が脳内の抽象的な記号処理だけでなく、身体の状態や運動能力によって形づくられるという考え方です。この立場では、ジェスチャーは思考の「出力」にとどまらず、思考そのものを支える役割を持つとされます。大きさや位置関係、動きの方向など、言葉だけでは伝えにくい空間的な情報を、手振りは直接的に表現できます。
心の理論とメンタライジング
他者の信念や意図、感情を推測する能力は「心の理論」と呼ばれ、その推論過程はメンタライジングと呼ばれます。人は表情や視線、姿勢といった手がかりから相手の内面を読み取っています。特に視線は、相手が何に注意を向けているかを示すと同時に、「この相手には意図がある」と感じさせる強い手がかりになると指摘されています。
シミュレーション理論とミラーニューロン
一方で、人は常に明示的な推論で他者を理解しているわけではありません。シミュレーション理論では、他者の行為を自分の運動表象で内的に再現することで、意図や感情を直感的に共有すると説明します。その神経基盤として注目されてきたのがミラーニューロン機構です。近年は、こうした予測的な行動理解とメンタライジングを統合し、対話中の相互理解をモデル化する研究も行われており、両者は対立ではなく補完関係にあると捉えられています。
マクニールの成長点仮説
言語と身振りの関係を説明する代表的な理論が、マクニールの成長点仮説です。ジェスチャーと発話は共通の伝達意図から同時に生まれ、言語チャネルと非言語チャネルに分かれて表現されると考えます。この見方に立てば、ジェスチャーは発話の飾りではなく、空間イメージや感情的なニュアンスなど、言葉とは異なる側面の情報を担う独立した表現手段です。この視点は、AIで「発話内容と意味的に一致した身振り」を生成すべき理論的根拠にもなっています。
生成AIによる非言語対話モデルの最新動向
マルチモーダルAIと身体性を持つ言語モデル
複数の情報チャネルを扱うマルチモーダルAIの発展により、テキストに加えて画像・音声・センサー情報を統合する大規模モデルが登場しています。たとえばGoogleのPaLM-Eは、大規模言語モデルに視覚情報やロボットの状態情報を直接入力として組み込み、言語理解と実世界での行動計画をつなげる試みです。現状はロボットのタスク実行が主な用途ですが、同様の枠組みが対話エージェントに広がれば、ユーザーの視線や身振りを文脈として理解する応用につながる可能性があります。
音声・テキストから全身の動きを生成する技術
発話に伴う身振り(共同発話ジェスチャー)の自動生成は、データセットの大規模化と生成モデルの高性能化を背景に関心が高まっている分野です。研究は「話す顔」の生成から上半身、さらに全身へと対象を広げています。音声から口の動きや基本的なリズム動作を生成しつつ、「手を振る」「うなずく」といった特定の動作をテキスト指示で制御できるフレームワークも提案されており、発話内容と身体表現を柔軟に組み合わせる方向へ進んでいます。
非言語信号の「認識」と「生成」の技術
認識:姿勢・表情・視線・声の抑揚を捉える
ユーザーの非言語信号を理解するには、コンピュータビジョンと音声処理の組み合わせが欠かせません。
- 姿勢推定:OpenPoseやMediaPipeなどで身体の関節位置を推定し、ジェスチャーや姿勢を捉える
- 表情認識:深層学習による表情分類や、顔のアクションユニット検出で微細な変化を把握する
- 視線推定:カメラや専用センサーで注視点を推定し、関心の対象や注意の向きを把握する
- プロソディ解析:声の抑揚やリズムから感情的なトーンや意図を推定する
これらの結果を統合し、「相手はいま何に注意を向け、どんな感情状態にあるか」というユーザー状態モデルを内部に持つことが、文脈に沿った応答の基盤になります。
生成:ルールベースからデータ駆動型へ
初期の対話エージェントでは、強調語でうなずく、指示語で指差すといった振る舞いを人手で定義するルールベースの手法が主流でした。解釈しやすい反面、動きが単調になりやすいという課題があります。現在は、モーションキャプチャーデータから学習するデータ駆動型、とりわけ深層学習による手法が中心です。音声波形や発話テキストを入力し、対応する身体動作の系列を出力するモデルが用いられ、音響的な手がかり(リズムや強勢)と意味的な手がかりの両方を入力することで、より適切な身振りが得られる傾向が報告されています。
深層生成モデルとスタイル制御
生成手法としては、GAN、VAE、拡散モデルなどが取り入れられています。
- GAN:判別器との競合学習により、滑らかで人間らしい動きを目指す
- VAE:潜在空間からのサンプリングで、動作のバリエーションを生み出しやすい
- 拡散モデル:ノイズから段階的に動作を精緻化し、高品質な生成が期待される
さらに重要なのがスタイルとパーソナリティの制御です。身振りの癖や頻度は人によって異なり、場面によっても変わります。話者スタイルを表すベクトルや感情ラベルで動作を変調し、「熱のこもった説明では大きく」「落ち着いた相談では控えめに」といった調整を実現する研究が進んでいます。人間同士の対話から応答パターンを学ぶ模倣学習も、自然な非言語行動を獲得する有力なアプローチです。
ジェスチャー生成研究のデータセットと評価手法
代表的なデータセット
- CMU Panoptic Studio:多数のカメラで多人数の対話を記録し、3次元の身体動作・音声を含む
- TED Gesture Dataset:TED講演の映像から抽出した、多数の話者のジェスチャーと音声のペア
- Talking With Hands 16.2M:二者間の対面会話を、手指の細かな動きまでモーションキャプチャーで記録
- BEAT:音声・テキストに加え、ジェスチャーの意味ラベルや感情ラベルが付与されたマルチモーダルデータ
- ZeroEGGS:少人数ながら高品質で、話し方のスタイルの違いを含むモーションデータ
研究目的に応じて、規模を優先するか、注釈の豊かさを優先するかを使い分けることが重要です。
主観評価・客観評価とGENEAチャレンジ
ジェスチャー生成の評価は難しく、現在も中心は人間による主観評価です。生成動画を見て「人間らしさ」と「発話への適切さ」を評点したり、正しい組み合わせの動画と別の発話の動作を付けた動画を比べさせたりする手法が用いられています。客観指標としては、生成動作と実際の人間の動作の分布の距離を測るFréchet Gesture Distance(FGD)や、多様性・滑らかさの指標が提案されていますが、意味的な適切さまでは捉えきれません。
そこで注目されているのが、複数のシステムを共通条件で比較するGENEAチャレンジです。その結果からは、動きの人間らしさは実測データに近づきつつある一方、発話内容との適切さにはまだ改善の余地があることが示唆されています。今後は「意味が伝わるか」「対話に貢献するか」を測る評価設計が課題です。
非言語コミュニケーションAIの応用分野
教育
説明内容と意味的に一致した身振りは、学習者の理解を深めるという研究があります。流れや形状を手で示すことで抽象概念がつかみやすくなり、子どもは特に身振りから多くを学ぶ可能性が指摘されています。AIチューターが適切なタイミングでうなずいたり指し示したりすることで、注意の誘導や学習意欲の維持に役立つと考えられます。
医療・福祉
健康支援の分野では、身体を持つ対話エージェント(ECA)の研究が進んでいます。共感的な表情やアイコンタクトを伴う対話は、利用者の信頼感や受容性を高める可能性があり、検診の受診勧奨や慢性疾患の自己管理支援などで活用が検討されています。高齢者の話し相手として、穏やかな相槌によって孤独感の軽減を目指す取り組みもあります。
カスタマーサービス
受付や案内に表情豊かなデジタルヒューマンを置く事例が増えています。笑顔でうなずき、身振りで方向を示すことで、無機質な音声応答よりも親しみやすい体験を提供できる可能性があります。顧客の感情を推定して応答を調整する研究も進んでいます。
社会実装に向けた倫理的課題
人間らしさの向上には慎重な検討も必要です。高齢者がAIを人と誤認するほどの共感表現は適切か、子ども向け教育AIの影響力をどう管理するか、表情や視線という機微な情報をどう扱うかなど、評価基準とガイドラインの整備が欠かせません。
まとめ
非言語コミュニケーションは、身体化された認知、心の理論、シミュレーション理論、成長点仮説といった認知科学の理論によって、その意義が多角的に説明されています。生成AIはこの知見を背景に、音声やテキストからジェスチャーを生成し、ユーザーの表情や視線を理解する方向へと進化しています。一方で、動きの「人間らしさ」に比べ、発話との「意味的な適切さ」や対話への貢献はまだ発展途上であり、評価手法の確立が大きな課題です。
次の研究テーマとしては、理論と実装をつなぐ「意味的に適切なジェスチャー生成」、話者交代やうなずきを含む「双方向・リアルタイムの非言語インタラクション」、そして文化差や倫理を踏まえた「社会的に受け入れられる非言語AI」の設計を掘り下げることが有望です。
コメント