はじめに:なぜ自己報告に頼らない心理測定が求められるのか
質問紙による心理測定は手軽ですが、回答者の自己呈示や社会的望ましさの影響を避けにくいという限界があります。一方、SNS投稿や日記、スマートフォンの行動ログなど、日常の中で自然に生まれるデータには、本人が意識していない個人差が表れている可能性があります。
本記事では、人がどれほど広く、多面的かつ柔軟に世界を認識し、外界と関わっているかを「世界開示」と呼びます。これを日本語の自然言語処理(NLP)と行動データから間接的に推定する研究設計について、概念定義、データ選択、特徴量設計、評価方法、倫理、実用化の順に解説します。
世界開示とは何か:経験への開放性との違い
確立した単一尺度ではないという前提
世界開示は、Big Fiveの「経験への開放性」のような確立した心理尺度ではありません。SNS言語から性格特性を予測する研究は蓄積されていますが、それが世界開示の妥当性を示すわけではない点に注意が必要です。最初から一つの総合スコアを機械学習で予測する設計は、何を測っているのかが曖昧になるおそれがあります。
テキストが表すのは「観測条件下での世界への開き方」
言語表出は、潜在的な特性だけで決まるものではありません。そのときの状態、場面、会話の相手、媒体の規範、話題への曝露の程度などが複合的に影響します。同じ人でも、職場チャットと匿名SNSとでは言葉遣いが大きく変わります。そのため、測定しているのは「世界そのもの」ではなく、「観測された条件下での世界への開き方」だと捉える必要があります。
4つの潜在軸で捉える多次元モデル
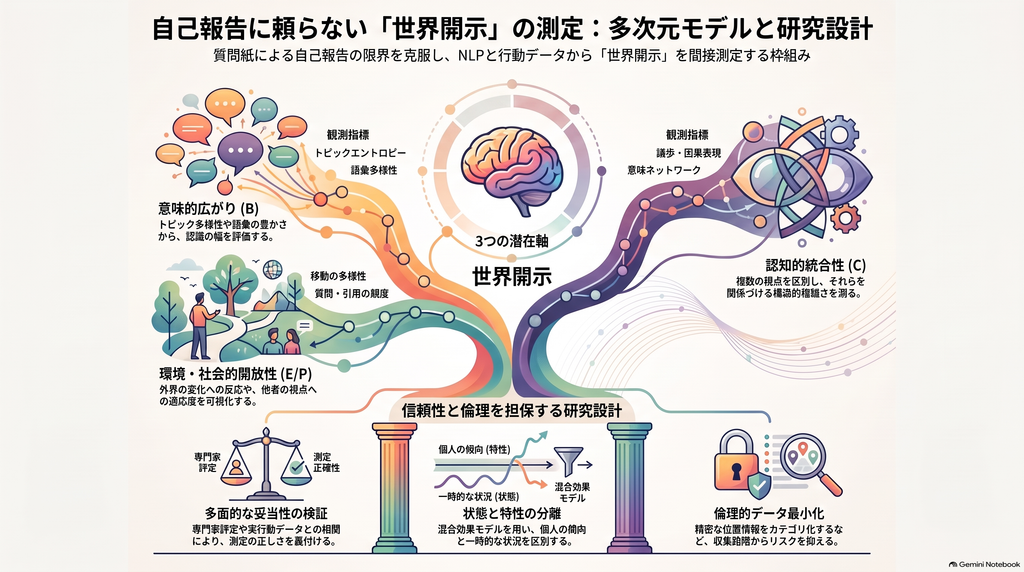
実用的な定義としては、世界開示を次の4軸からなる多次元の構成概念として扱う方法が有力です。
| 潜在軸 | 内容 | 観測候補 |
|---|---|---|
| 意味的広がり(B) | 触れている概念・話題の範囲と多様性 | トピックエントロピー、埋め込みの分散、語彙多様性 |
| 認知的統合性(C) | 複数の視点や矛盾を区別し、関係づける傾向 | 譲歩・因果表現、統合的複雑性、意味ネットワーク |
| 環境結合性(E) | 外界の変化が言語・行動の変化と結びつく程度 | 移動の多様性、出来事後の話題変化 |
| 社会・語用論的開放性(P) | 他者の視点への応答と対話上の適応 | 質問率、言い換え、引用、ターン交替 |
各軸はベクトルとして報告し、因子分析や縦断データで共通因子が確認されてから総合スコア化するのが妥当です。また、階層モデルを使って長期的な傾向(trait)と一時的な状態(state)を分けることで、「もともと開放的な人」と「今だけ新しい環境にいる人」を混同しにくくなります。
データソースの選び方とバイアス
テキスト系データ(SNS・チャット・日記)
SNS投稿は量が多く長期間の履歴を追えますが、自己呈示や推薦アルゴリズムによる曝露差の影響を受けます。チャットログには質問や言い換えなど語用論的な特徴が豊富に含まれる一方、会話相手という第三者の情報を含むため倫理的な負荷が大きくなります。日記は個人内の縦断分析に向いており、パイロット研究の出発点として扱いやすいデータです。
行動・音声・生体データ
位置情報やアプリの利用ログは、言語に依存せずに新規環境との接触を捉えられますが、再識別されるリスクが非常に高いデータです。音声は自然な発話を得やすい反面、周囲の人の声を録音してしまう危険や、音声認識の誤りによる偏りがあります。生体データは状態を補助的に示す変数として使うのが適切です。
なお、センサーデータを文章に変換してからBERTに入力する設計は推奨されません。測定誤差やサンプリング頻度などの情報が失われるためです。数値系列は数値用のエンコーダ、言語は言語用のエンコーダで処理し、中間層または予測層で統合するのが原則です。
日本語NLP・テキストマイニングの特徴量設計
日本語前処理のポイント
日本語では形態素の分割方法そのものが分析結果を左右するため、前処理の仕様を固定して公開することが重要です。GiNZAやSudachiで品詞、原形、係り受け、固有表現を取得し、個人を識別できる表現はマスキングします。「かも」「たぶん」「笑」などの表現は心理的・語用論的な特徴になり得るため、安易に削除しないようにします。学習データとテストデータの分割は、投稿単位ではなく人物単位で行う必要があります。
軸ごとに有望な特徴量
- 意味的広がり:文章量に比較的左右されにくいMATTRやMTLD、トピックエントロピー、文埋め込み間の距離を組み合わせます。文章量が多い人ほど「世界が広い」ように見えてしまうため、語数をそろえた感度分析が欠かせません。
- 認知的統合性:「ただし」「一方」といった語の頻度だけでは不十分です。視点を区別し、さらにそれらを関係づける構造をまとめて検出する必要があり、統合的複雑性の自動評価研究が参考になります。
- 環境結合性:場所の多様性と、言語の意味的な中心の変化とが個人内でどのように連動するかを見ることで、新しい環境との接触が語られる内容に反映されるかを検証できる可能性があります。
感情分析については、日本語SNSの情動データセットであるWRIMEが有力な基盤になります。WRIMEでは、読み手が書き手の感情を完全には読み取れないことが示されており、文章から推定した状態を本人の内面そのものとみなせないことを示唆しています。
因果推論は予測の延長ではない
「移動した後に新しい話題が増えた」という観察だけでは、因果関係があるとは言えません。休日や健康状態などが両方に影響している可能性があるためです。まずDAGで交絡要因を定義し、固定効果モデルを活用し、可能であればランダム化による介入を行います。因果発見アルゴリズムの結果は、あくまで仮説を生み出すための材料として扱うべきです。
正解ラベルがない構成概念をどう評価するか
多特性・多方法による妥当化
研究者が主観的に付けたラベルをモデルで再現し、それをもって妥当性とみなすのは循環論法です。代わりに、次の4つの観点から妥当性を積み重ねます。
- 複数分野の専門家による軸ごとの評定
- 開発段階に限った、Big Five開放性など既存尺度との収束
- 新しい場所の探索や多様な情報源への接触といった実際の行動との関連
- 新規情報への接触をランダム化した実験での予測妥当性
最低限報告すべき評価指標
予測精度に加えて、再検査信頼性、評定者間の一致度、校正、弁別妥当性(外向性や投稿量との区別)、増分妥当性、別の時期や媒体での検証、サブグループごとの公平性を報告することが求められます。同じ人から繰り返し得たデータは互いに相関するため、混合効果モデルなどでクラスタ構造を考慮する必要があります。
倫理・プライバシー・公平性への配慮
本人が意識していなかった特性を推定すること自体がリスクになり得ます。同意は、テキスト、位置、音声、生体、二次利用といったデータの種類ごとに個別に取得し、途中で停止できるようにするのが望ましいでしょう。精密な座標は端末上で「交通施設・新規訪問」のような粗いカテゴリに変換し、元のデータは破棄するなど、収集の段階からデータを最小化する設計が有効です。
また、移動の多様性が低いことをそのまま「開放性が低い」と判定すると、介護者や障害のある人、地方の居住者に構造的な不利益を与えかねません。環境の機会と心理的な傾向を分離することは、構成概念妥当性の一部として扱うべきです。
日本の個人情報保護法制は改正が進んでいるため、研究開始時だけでなく、施行の前後にも法令やガイドラインを確認し直す体制が必要です。
実用化に向けたロードマップ
研究用途としての実現可能性は一定程度見込めますが、採用や信用評価など影響の大きい用途へすぐに導入するのは難しいと考えられます。段階的な進め方としては、次のような順序が合理的です。
- 短期:4軸の定義とコードブックの作成、日本語テキストと専門家評定によるパイロット研究
- 中期:規模を拡大した縦断研究、粗い粒度の行動データの追加、別の集団での外部検証
- 長期:多施設での事前登録型の介入試験、オンデバイス処理、プライバシー保護型の学習
最終的に目指す形は、「世界開示度◯点」と断定する査定器ではなく、軸ごと・期間限定で、使用したデータ量と不確実性を明示したプロファイルです。
まとめ
世界開示の間接測定では、機械学習の精度そのものよりも、構成概念の妥当性、交絡、プライバシー、公平性をどう扱うかが成否を分けます。4つの潜在軸を多次元のまま扱い、テキストと行動データを組み合わせた縦断設計で、状態と特性を分けて検証することが現実的な第一歩になります。
今後の研究の中心となるのは、データ最小化と測定の妥当性を同時に満たすことです。つまり、必要最小限のデータでどこまで妥当な推定ができるかを問うことです。
コメント