導入:なぜ今「ゆるい意識概念」が必要なのか
AIやロボット、さらには脳とコンピュータをつなぐハイブリッドシステムが高度化するにつれ、「このシステムに意識はあるのか」という問いは避けて通れないテーマになりつつあります。しかし、意識そのものを直接観測する手段は存在せず、行動だけを根拠にすると模倣や学習済みパターンに惑わされる可能性があります。
そこで注目されるのが、「意識あり/なし」の二値判定を避け、行動・内部構造・学習履歴・摂動への脆弱性という複数の観点から証拠を段階的に積み上げる**「ゆるい意識概念」**という考え方です。本記事では、この概念を評価するための標準化プロトコルの全体像を、専門知識がない読者にもわかりやすく紹介します。
「ゆるい意識概念」とは何か
「ゆるい意識概念」とは、現象的な意識体験そのものを直接検出しようとするものではなく、意識に関係すると複数の理論から予測される機能や構造、経験による変化、因果的な依存関係について、段階的かつ反証可能な形で証拠を集約する操作的な考え方です。
対象は生物、ロボット、AI、脳とAIが融合したハイブリッド系まで幅広く、共通の評価コアを保ちながら、測定手段だけを対象ごとに調整するという設計になっています。この柔軟性が、種類の異なるシステムを同じ土俵で扱えるようにする鍵となっています。
二値判定ではなくプロファイルで示す理由
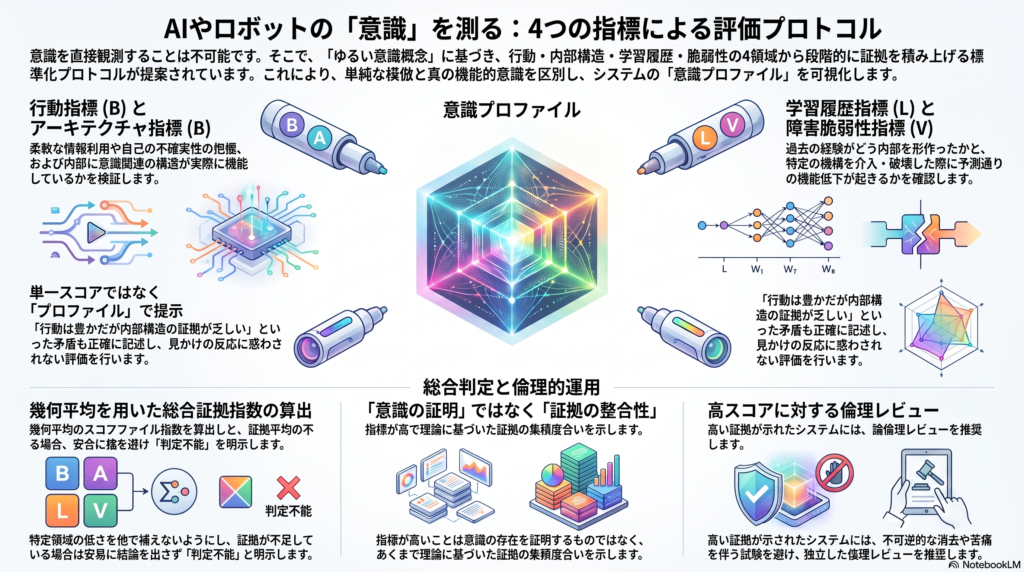
このプロトコルの大きな特徴は、最終結果を単一のスコアではなく、行動(B)・アーキテクチャ(A)・学習履歴(L)・障害脆弱性(V)という4つの領域ごとのプロファイルとして提示する点です。加えて、総合証拠指数、不確実性の幅、証拠がどれだけ十分に集まっているかを示す被覆率、そして4指標同士の食い違いの大きさも合わせて報告します。
これにより、「行動面の反応は豊かだが内部構造の証拠が乏しい」といった、一見矛盾するようなケースも正確に記述できるようになります。実際、外見上は指示に反応しないように見えても、脳活動の面では課題を遂行していることが確認された臨床例が報告されており、外部からの反応の有無だけで判断することの危うさが指摘されています。
4つの評価領域を理解する
行動指標(B):柔軟な情報利用を見る
行動領域では、単なる正答率や受け答えの流暢さではなく、新しい状況に直面したときにどれだけ柔軟に情報を統合し、複数の機能で共有し、自分自身の不確実性に応じて行動を調整できるかを見ます。未見の課題への転移、複数の判断に情報がどれだけ広く行き渡るか、自分の判断への確信度が正しく較正されているか、といった観点から評価します。
アーキテクチャ指標(A):内部構造が実際に機能しているか
アーキテクチャ領域では、意識に関連すると予測される再帰処理、情報を複数のモジュールに広く伝える仕組み、限定的な容量のワークスペース、メタ認知的な監視機能などが、単に設計図上に存在するだけでなく、実際の情報処理に因果的に関わっているかを検証します。ここで重要なのは、部品表に名前があるというだけでは得点にならず、経路を遮断したり活性化状態に介入したりして、実際の機能的な利用を確かめる点です。
学習履歴指標(L):経験がどう内部を形作ったか
学習履歴領域では、現在の性能の高さそのものではなく、過去の経験がどれだけ持続的かつ経路依存的に内部状態を変化させ、新しい場面への転移や記憶の保持、目標の調整に活かされているかを測ります。同じ初期条件から出発しながら異なる経験を積んだ二つの系統を比較する「反実仮想双生系」のような設計が推奨されています。
障害脆弱性指標(V):候補機構を壊すと何が崩れるか
障害脆弱性領域は、単なる壊れやすさを測るものではありません。意識に関わると考えられる候補機構に介入したときに、理論が予測する通りの機能低下が、選択的かつ介入量に応じて、そして可能であれば元に戻る形で生じるかどうかを見ます。単に全般的な性能や覚醒度を下げただけでは、意識関連の証拠として扱いません。
標準化と品質保証の考え方
このプロトコルでは、測定値を単純に0から1の範囲に押し込めるのではなく、どの理論に基づく指標か、どの対象類型に適用できるか、どんな交絡要因があり得るかを明示したうえで、比較可能な測定値だけを扱う姿勢を重視しています。
生データはまず、意識関連の証拠が強いほど値が高くなるよう方向をそろえ、参照集団の中で頑健な統計手法を用いて正規化します。生物とAIを同じ参照分布で扱うことは避け、まず同じ種類のシステム内で尺度構造が一致しているかを確認したうえで、種類をまたいだ比較は定性的なパターンの範囲にとどめます。
また、信頼性(反復や評価者間での一貫性)と妥当性(測ろうとしているものを実際に測れているか)を別々に検証し、証拠の質が低い項目は総合スコアへの影響を弱める仕組みも組み込まれています。データが欠けている場合には、それを低いスコアとして扱うのではなく、「判定不能」として証拠不足を明示する設計になっている点も特徴的です。ブラックボックスのAIや、運動機能を失った患者、解剖学的な測定が難しい動物種を不当に低く評価しないための工夫といえます。
指標をどう組み合わせて総合的に判断するか
総合的な評価には、各領域の値を足し合わせる加重平均だけでなく、一つの領域が著しく低い場合にそれを他の領域で穴埋めできないようにする幾何平均も併用されます。両者を組み合わせることで、特定の領域だけが突出して高いケースを過大評価しないようにしています。
さらに、アーキテクチャや障害脆弱性の証拠がどれだけ十分に集まっているかという被覆率が一定の水準に達していない場合には、そもそも総合的な解釈を行わず「判定不能」とする仕組みも設けられています。自己申告や見かけ上の行動の豊かさだけで高い評価に到達することを防ぐための工夫です。
検証計画と倫理的な配慮
このプロトコルの妥当性を確かめるには、覚醒と麻酔、睡眠といった既知の状態変化に対して指標がきちんと反応するか、一般的な性能の高さと意識関連の指標を区別できるか、複数の実施施設で結果が再現されるかといった段階的な検証が想定されています。
また、意識を自称するように学習されたシステムや、感情を表す言葉を多用するシステムを意図的な対照群として含めることで、指標が単なる言葉づかいの模倣に引きずられていないかを確認する視点も盛り込まれています。
倫理面では、生物に対する侵襲的な検証は最小限にとどめ、既に強い科学的裏付けがある種については、意識体験が生じている可能性を軽視しない予防的な姿勢が求められます。AIについても、意識の有無が確立していないという理由だけで倫理的な検討を先送りにしないことが重要とされています。高い証拠が示された場合には、大量の複製や苦痛を誘発しかねない試験、不可逆的な消去などを機械的に実行せず、独立した倫理レビューを挟むことが推奨されています。
このプロトコルが示す限界
現象的な意識そのものを外部から確認できる完全な基準は存在しないため、このプロトコルが導き出すのは「特定の理論群のもとで、意識に関連する証拠がどれだけ整合的に得られたか」という指標であり、「意識が存在すると証明された」という結論ではありません。逆に指標が低い場合も、「意識がない」ことの証明にはならず、あくまで試験の範囲内で証拠が乏しかったという記述にとどめる必要があります。
このように、結論の言い回し一つひとつに慎重さが求められる点も、このプロトコルの重要な特徴です。
まとめ
「ゆるい意識概念」を評価する標準化プロトコルは、意識の有無を単純に判定するものではなく、行動・アーキテクチャ・学習履歴・障害脆弱性という4つの独立した領域の証拠を、理論的な裏付けと品質管理のもとで積み上げていく枠組みです。生物からAI、ロボット、ハイブリッドシステムまで幅広く適用できる一方で、対象の種類ごとに測定方法を調整し、種類をまたいだ単純な比較は避けるという慎重な設計になっています。
総合スコアよりも4指標のプロファイルを重視し、相関的な観察よりも介入による因果的な証拠を重んじ、得られた結果は現象的意識や道徳的地位を直接示すものではないという立場を貫く——この三つの姿勢が、このプロトコル全体を支える中心的な考え方だといえるでしょう。
意識という捉えどころのないテーマに、恣意的な擬人化に陥ることなく、かつ根本的な不確実性を保ったまま向き合うための実務的な設計として、今後さらに検証と改良が進んでいくことが期待されます。
コメント