はじめに:なぜロボットに「自分を疑う力」が必要なのか
強化学習や模倣学習で訓練したロボットは、学習時と似た環境では高い性能を発揮します。しかし、照明の変化、センサの故障、床の摩擦の違いなど、想定外の状況では突然失敗する可能性があります。実機での失敗は機体の損傷や安全上のリスクに直結するため、「どれだけ賢いか」だけでなく「自分がいま信頼できる状態かを判断できるか」が問われるようになっています。
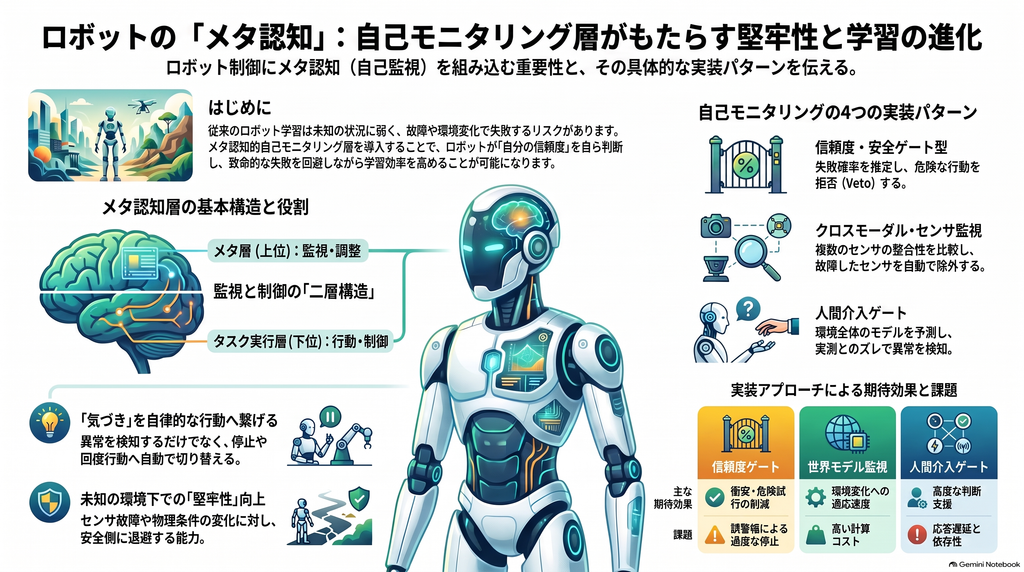
本記事では、この判断を担うメタ認知的自己モニタリング層について、定義、関連研究、設計パターン、評価方法、実機導入のステップを順に整理します。
メタ認知的自己モニタリング層とは
「監視」と「制御」の二層構造
人工メタ認知の研究では、タスクを実行する処理(object-level)と、その処理を監視・調整する処理(meta-level)を分ける二層構造が基本的な枠組みとされています。ロボット制御に当てはめると、通常の方策(ポリシー)が行動を出力し、その上位にあるメタ層が「この出力をいま信頼してよいか」を判定する構成になります。
ここでいうメタ認知は、意識や主観的な自己認識を意味しません。自己の能力限界、不確実性、センサの状態、予測の失敗をモデル化し、その推定結果を行動制御に戻す仕組みを指します。
異常検知器との違い
単に異常スコアを出力するだけの仕組みは、メタ認知層とは呼べません。重要なのは、その推定が次のような自己制御につながっていることです。
- 行動をそのまま実行する
- 危険な行動を拒否(veto)する
- 回復行動や安全な方策に切り替える
- 再計画・オンライン適応を行う
- 人間に問い合わせる、または停止する
つまり、「気づく」だけでなく「気づいたうえで振る舞いを変える」ことが、メタ認知層の要件といえます。
先行研究からわかること
「メタ認知」を明示した研究はまだ少ない
「robotic metacognition」という名称を明示し、学習の収束速度やサンプル効率を直接比較した査読済み実験は、現時点ではまだ限られています。ドイツ航空宇宙センター(DLR)による提案も、ハードウェア故障への対処を目指す将来構想の段階にあります。
そのため、実際の評価では、メタ認知と機能的に近い研究系列をまとめて検討するのが現実的です。具体的には、分布外(OOD)検知、不確実性推定、失敗予測、安全な回復方策、センサ診断、世界モデルの予測誤差、オンライン適応、人間介入の判定などが該当します。
堅牢性に関する証拠は比較的強い
周辺研究からは、堅牢性の向上を示唆する結果が得られています。
- Safe Visual Navigation(RSS 2017):新規入力を検知すると安全な事前方策へ切り替える方式で、既知環境での速さを保ちつつ未知環境で安全側に退避できることが示されました。
- Recovery RL:失敗領域を予測する評価器と回復方策への切り替えにより、制約違反とタスク成功のバランスが改善したと報告されています。
- Crossmodal Compensation Model(ICRA 2021):再構成誤差から壊れたセンサを検知して除外し、残りのセンサで補うことで、学習時に経験していない故障下でも方策を使い続けられる可能性が示されました。
学習効率への効果は「閉ループ化」が鍵
一方、「モニタを付けるだけで通常環境の性能が上がる」という直接的な証拠は弱いのが現状です。学習効率の改善が期待しやすいのは、監視結果をデータ収集やモデル更新に戻す閉ループ構成の場合です。
たとえば、不確実性を扱う確率的ダイナミクスモデルを用いたPETSは高いサンプル効率を示しました。また、ThriftyDAggerは新規性とリスクに応じて人間への問い合わせを絞り込み、性能と監督負担の両立を報告しています。
自己モニタリング層の4つの設計パターン
A:信頼度・安全ゲート型
方策の内部表現、評価器のばらつき、OODスコアなどから失敗確率を推定し、実行・拒否・回復・停止を選びます。衝突や危険な試行の削減が期待される一方、誤警報が多いと過度に停止してしまうリスクがあります。
B:予測型世界モデル監視
行動履歴から将来を予測し、予測と現実のずれ(驚き)や不確実性をもとに再計画や適応を行います。サンプル効率や環境変化への対応に潜在的な効果がありますが、モデルの偏りや計算コストが課題になります。
C:クロスモーダル・センサ健全性監視
カメラ、深度センサ、力覚センサなどの整合性を比較し、信頼できないセンサを除外・減衰・補完します。センサ故障やノイズに強くなる可能性がある一方、複数センサが同時に壊れる共通原因故障には弱い面があります。
D:新規性・リスクに基づく人間介入ゲート
ロボットが「この状況では自律判断の根拠が足りない」と判断したときだけ人間に問い合わせます。模倣学習でのデータ効率や安全性の向上が見込まれますが、人間への依存という新たな制約が生まれます。
推奨は階層的なハイブリッド構成
単一の巨大な「内省ネットワーク」よりも、処理速度の異なる層を組み合わせる構成が有望と考えられます。
- 高速層:センサ健全性チェックと失敗リスクゲート(A+C)
- 中速層:回復行動、行動拒否、安全方策への切り替え
- 低速層:世界モデルの予測誤差、オンライン適応、リプレイの優先度付け(B)
実機導入の第一候補はA+Cの組み合わせで、世界モデル型は第二段階で追加するのが安全と考えられます。
効果を正しく測るための評価設計
「監視だけ」「監視+制御」「監視+学習」を分けて比較する
効果の出どころを特定するには、次の3条件を分けて評価する必要があります。
- 監視のみ:スコアを記録するが方策は変えない
- 監視+制御:拒否や回復を実行する
- 監視+学習:データ収集、リプレイ、オンライン適応まで変える
この切り分けがないと、改善が異常検出によるものか、追加学習によるものかを判断できません。
学習性能と自己評価の正しさは別に測る
学習性能は最終報酬だけでなく、一定の成功率に到達するまでのステップ数や学習曲線全体の面積で比較すると、「どれだけ早く使える方策になったか」が見えてきます。
さらに、モニタ自身の性能も独立して評価すべきです。失敗予測の識別性能や確率の較正度、見逃し率、誤警報率、検知のタイミングなどを記録することで、「本当に自己評価能力が上がったのか」を確認できます。
複合的なストレステストが重要
ノイズ、センサの欠落や固着、遅延、質量や摩擦の変化、未知の環境、敵対的な観測摂動などを段階的に加えて試験します。特に実機では複数の不具合が同時に起こり得るため、単一要因の試験に加えて、複数要因を組み合わせた複合故障の試験が欠かせません。
シミュレーションから実機への段階的な導入
実機にいきなりセンサ遮断や敵対的摂動を加えるのは、安全性と再現性の両面で適切ではありません。次の順序で進めるのが望ましいとされます。
- シミュレーション:Habitat、RLBench、ManiSkill2などで多数の条件を比較し、有望な方式を絞り込む
- ハードウェア・イン・ザ・ループ:実際の制御系とドライバを動かしつつ、遅延やタイミングのずれを測る
- シャドーモード:モニタは制御せず判断だけを記録し、実際の失敗や介入と照合する
- 保護付き実機実行:速度・トルク制限や独立した非常停止を備えた状態でメタ制御を有効化する
学習ベースのモニタとは独立した従来型のハード安全層を残すことが重要です。モニタが誤判断する可能性を前提にした多層防御の考え方です。
期待される効果と注意点
主な効果は「失敗の手前で振る舞いを変える」こと
既存の知見を総合すると、メタ認知層の主効果は、通常条件での最高性能の向上よりも、失敗を予測して制御方式を変えることによる重大な失敗の低減と、環境変化後の再適応の速さに現れる可能性が高いと考えられます。
結果の読み方に注意する
- 通常性能は同じで堅牢性だけ向上した場合:学習能力そのものではなく、危険な使い方を抑えた効果と解釈すべきです。
- モニタの精度は高いのに成功率が上がらない場合:しきい値、回復方策、切り替えのタイミングに問題がある可能性があります。
- 堅牢性は上がったが通常性能が落ちた場合:保守的すぎる判定を疑い、介入率や行動を控えた割合も併せて確認します。
モニタ自身も分布の変化にさらされる
モニタ自体も想定外の状況では判断を誤る可能性があります。「モニタを監視するモニタ」を無限に重ねるのではなく、較正データ、OOD検知、ハード安全層、シャドーモードでの検証によって境界を設けるのが現実的です。また、方策とモニタを同時に学習させると追跡対象が動いてしまうため、初期段階では方策を固定してモニタを較正し、その後交互に更新する方法が分析しやすいでしょう。
まとめ
メタ認知的自己モニタリング層は、ロボットが自分の不確実性やセンサ状態を把握し、その結果に応じて行動を切り替える上位層です。先行研究からは、特に分布外環境、センサ故障、環境変化への堅牢性を高める可能性が示されています。一方で、学習効率の向上は監視結果を学習に戻す閉ループ構成で期待しやすく、「メタ認知」を明示した定量研究はまだ発展途上です。
実装では、信頼度ゲートとセンサ健全性監視から始め、回復方策、世界モデルと段階的に拡張し、シャドーモードを経て実機に導入する流れが現実的です。評価では、学習曲線、自己評価の較正、ノイズ耐性、センサ遮断時の性能、環境変化からの回復時間、計算遅延を同じ実験系で示し、「学習能力を高めたのか、安全な退避機構として働いたのか」を切り分けることが今後の研究の焦点になります。
コメント